
 五度妙笔
 企业透视镜
 API商城

 数据库
紫山龙霖GalaxSphere荣登MLPerf Storage v3.0四大场景榜首之AI训练
以下文章来源于苏州紫山龙霖信息科技有限公司,作者紫山龙霖
在全球权威
AI
性能基准 MLPe
rf
Storage v3.0 的AI Training测试中,紫山龙霖(国芯科技参股企业)GalaxSphere从数据带宽、
GPU
承载能力、横向扩展性和单位效率等多个维度,验证了面向大规模AI训练集群的高效数据供给能力。
随着大模型与多模态AI快速演进,AI训练正从几十张GPU迈向千卡、万卡集群。GPU越多、算力越强,对数据供给能力的要求也越高。
如果数据送得不够快,GPU就只能等待,昂贵的算力难以充分释放。因此,AI基础设施比拼的不只是GPU数量,更是数据能否持续、稳定、高效地到达GPU。
两类训练负载,全面考验AI数据供给能力
MLPerf Storage v3.0 AI Training测试涵盖3D U-Net和Re
ti
naNet两类典型负载:前者侧重大文件连续读取,考验存储系统的高带宽吞吐能力;后者以大量图像并发访问为特征,重点考验小文件与高并发处理能力。
两类负载覆盖了AI训练中的典型数据访问模式,GalaxSphere在两类测试中均取得突出表现。
高带宽:最高433.36 GiB/s,让GPU等待更少
在3D U-Net训练场景中,GalaxSphere:
每客户端读取带宽达到142.83 GiB/s,领先第二名2.11倍;
每RU设备读取带宽达到433.36 GiB/s,领先第二名3.22倍。
高带宽意味着单位时间内可以向GPU提供更多训练数据,从而减少GPU因等待数据产生的空闲。
而在更加考验小文件、高并发访问能力的RetinaNet场景中,GalaxSphere每RU设备读取带宽达到25.85 GiB/s,领先第二名1.61倍。
这说明GalaxSphere的性能优势并非局限于大文件顺序读取,在视觉AI等大量小文件、高并发数据访问场景下,同样能够提供领先的数据供给能力。
AI Training关键性能结果


AI训练:3D U-Net每客户端性能排名第一
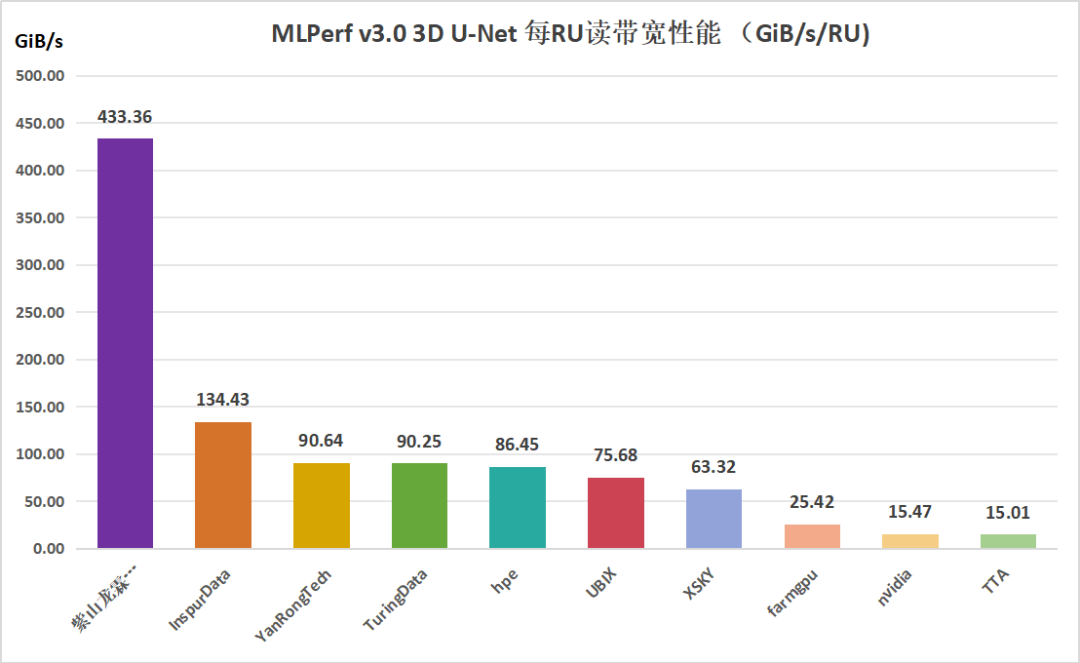
AI训练:3D U-Net每RU设备性能排名第一
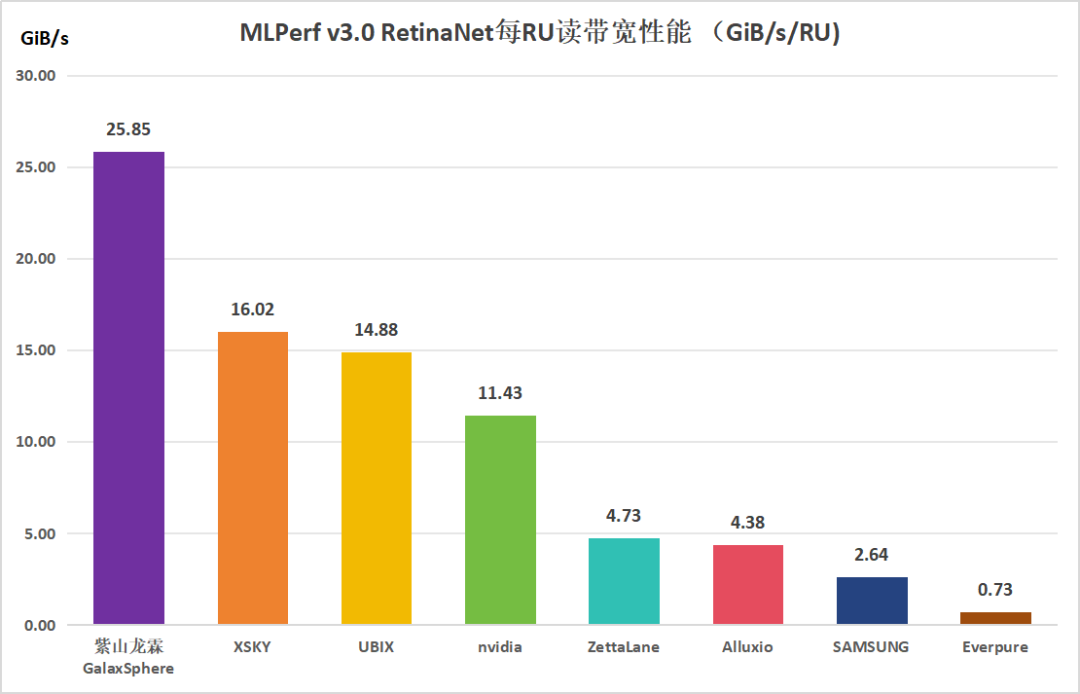
AI训练:RetinaNet每RU设备性能排名第一
支撑更多GPU:每RU最高可支持200张B200
对于AI数据
中心
来说,仅看存储带宽还不够。一个更直接的指标是:相同基础设施资源,究竟能够支撑多少GPU持续运行?
在3D U-Net测试中,GalaxSphere:
每客户端可支持26张B200,领先第二名2.17倍;
每RU设备可支持80张B200,领先第二名3.2倍。
在RetinaNet场景中,GalaxSphere每RU设备可支持200张B200,领先第二名1.74倍。
这意味着,在相同机柜空间下,GalaxSphere能够为更多GPU持续提供数据。对于当前受到机柜空间、电力和散热资源约束的大规模AI数据中心而言,存储基础设施正在从单纯追求“性能更高”,进一步转向追求用更少的基础设施资源支撑更多GPU算力。
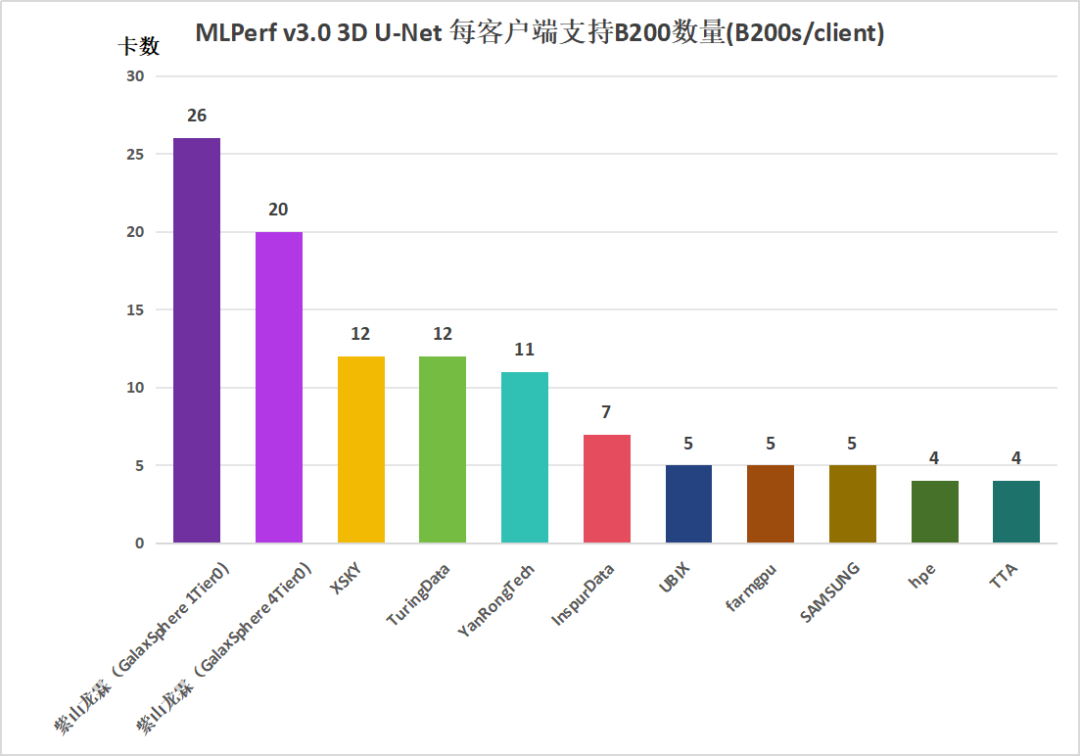
AI训练:3D U-Net每客户端支持B200数量排名第一
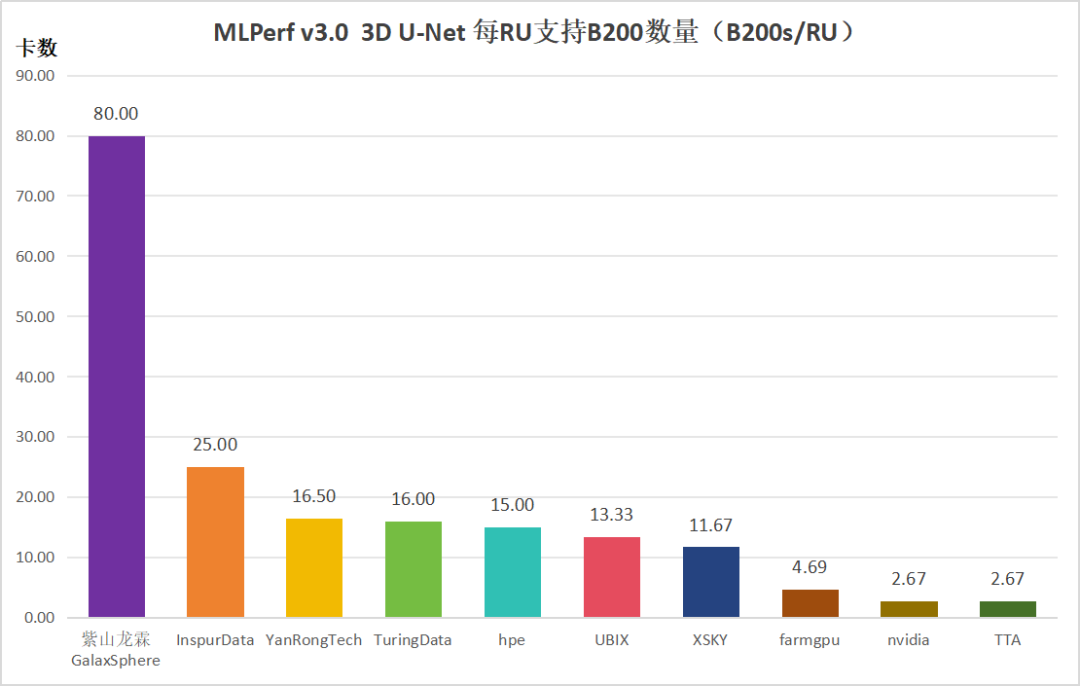
AI训练:3D U-Net每RU设备支持B200数量排名第一
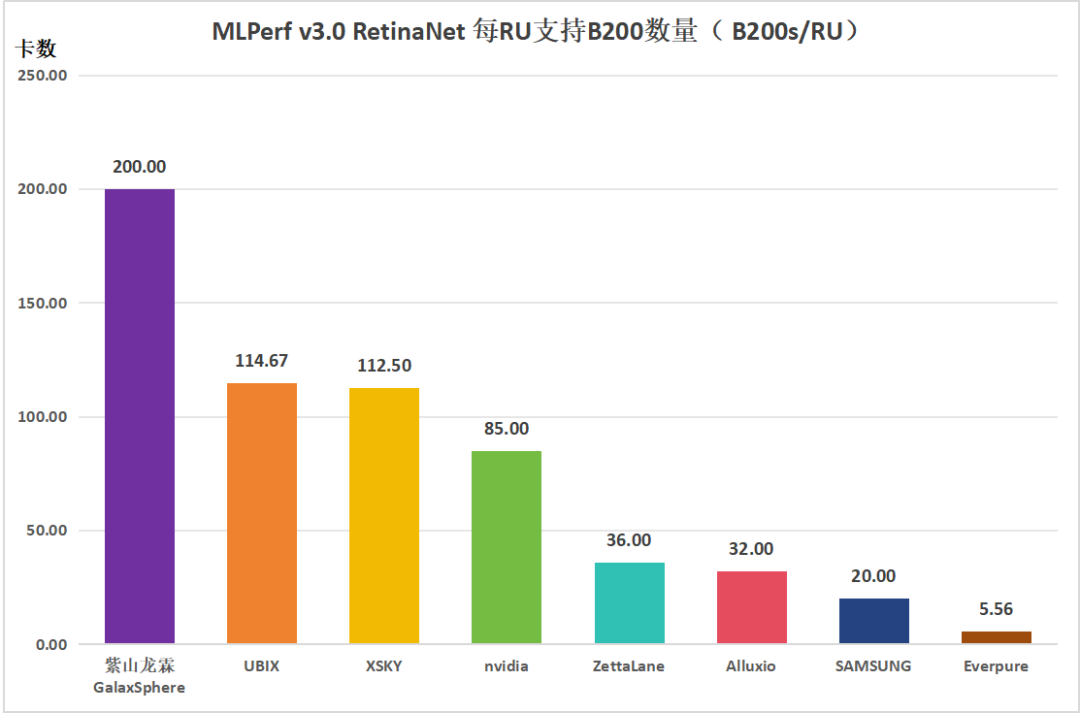
AI训练:RetinaNet每RU设备支持B200数量排名第一
从1个节点到4个节点,性能随集群持续扩展
单节点性能领先,只是AI存储能力的一部分。当GPU集群从几十张扩展到数百、数千张时,更关键的问题是:存储性能能否随着算力规模同步增长?
此次测试分别部署1、2、3、4个GalaxSphere Tier0节点,对系统的并行I/O能力与横向扩展能力进行了验证。
Tier0横向扩展测试


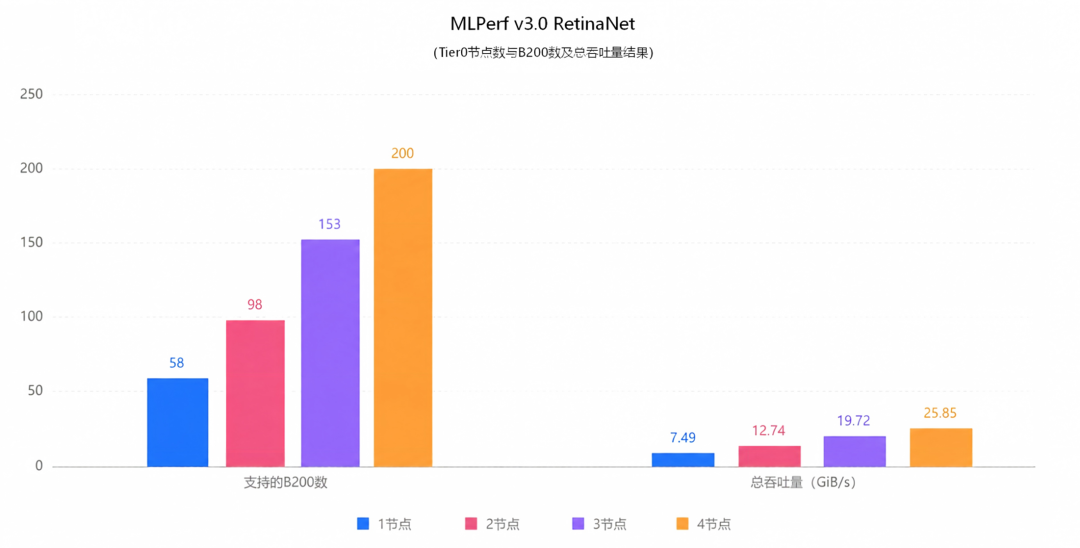
AI训练中的GPU规模和总吞吐量扩展性测试结果
随着Tier0节点由1个增加至4个:
在3D U-Net场景中,支持B200数量从26张提升至80张,总吞吐量从142.83 GiB/s提升至433.36 GiB/s。
在RetinaNet场景中,支持B200数量从58张提升至200张,总吞吐量从7.49 GiB/s提升至25.85 GiB/s。
测试结果显示,随着Tier0节点数量增加,系统支持的GPU数量和总吞吐量均持续增长,体现出良好的横向扩展能力。这也验证了GalaxSphere在主数据集可100%驻留本地的最佳测试场景下,面向更大规模GPU集群持续扩展数据供给能力的架构潜力。
AI基础设施正在进入“单位效率”竞争
当AI集群规模越来越大,真正稀缺的资源已经不仅是性能,还包括机柜空间、电力和散热能力。
这也意味着,AI存储的评价指标正在从“总带宽有多高”,进一步演进为:每一个RU、每一瓦电,能够输出多少有效性能?
性能测试结果为了解存储行业的现状(包括能效)提供了独特而重要的见解。本地部署的Checkpoint写入测试结果中,平均速率为每瓦 14 MiB/秒,最高可达 201 MiB/秒。同样,UNet3D 读取测试结果中,平均速率为每瓦 34 MiB /秒,最高可达 277 MiB /秒。“测试结果展现了广泛的能效水平,”Ande
rs
on 表示,“这对为
人工智能
应用采购存储解决方案的利益相关者而言,是至关重要的性能信息。这也表明,存储行业仍有很大的提升空间,我们鼓励所有供应商针对这一指标进行优化。”——ML Commons
在MLPerf Storage v3.0 3DU-Net读取测试中,GalaxSphere每RU设备读取带宽达到433.36 GiB/s,测试功耗为1600W,平均达到277 MiB/s/W,为该项测试最高值。
高性能与高单位效率同时具备,意味着在有限的数据中心空间和功耗预算下,可以用更高效的存储基础设施支撑更大规模的GPU算力。
不只是更快的存储,而是更高效的数据供给
从此次MLPerf Storage v3.0 AI Training测试可以看到,GalaxSphere体现出的并非单一性能指标优势,而是一套面向AI训练的数据供给能力:
更高带宽:让数据更快到达GPU,减少训练过程中的I/O等待;
更高GPU承载密度:让更少的基础设施资源服务更多算力;
持续横向扩展:让数据供给能力跟随GPU集群共同增长;
更高单位效率:降低机柜、电力和散热资源压力。
GalaxSphere基于紫山龙霖自主研发的GLFS全局数据
操作系统
,通过面向AI场景的数据平面架构,将高性能数据服务与计算节点本地NVMe Tier0加速能力相结合,使热数据能够更加靠近算力,为大规模AI训练持续提供高效的数据供给。
数据来源:MLPerf Storage Results. URL:https://mlcommons.org/benchmarks/storage/
存储
存储
+关注
关注
13
文章
5171
浏览量
91571
gpu
gpu
+关注
关注
28
文章
5510
浏览量
137413
AI
AI
+关注
关注
92
文章
45485
浏览量
306218
原文标题:紫山龙霖GalaxSphere荣登 MLPerf® Storage v3.0 四大场景榜首之AI训练:让GPU持续“吃饱数据”
文章出处:【微信号:gh_ff276752357a,微信公众号:苏州国芯科技】欢迎添加关注!文章转载请注明出处。


