五度妙笔
 企业透视镜
 API商城

 数据库
AI 液冷冷板技术路线要变天?
关注公众号,点击公众号主页右上角“ · · · ”,设置星标,实时关注旺材芯片最新资讯
AI 液冷冷板要变天:我翻完英伟达、华为、谷歌路线图,只信三句
一份台系散热大厂的演讲,在圈里被当考卷传。我把英伟达、华为、谷歌三条真实路线图翻完,发现这套判断的前提就站不住——真正被卡住的不是英伟达,是华为;而 14 家宣称能做冷板的大陆厂,大概率接不住下一代。 |
八月中,开放计算项目(OCP,Open Compute Project,数据中心硬件的开放标准组织)亚太峰会上,AVC(奇鋐,台系散热大厂)研发副总裁丢出一篇演讲,八条判断把「2027 年之后冷板还能不能做」的门槛,从工艺问题抬到了半导体制造问题。
我读完的第一反应是:这套判断的前提值得商榷。散热厂有动机把问题讲大、把订单周期讲长——「芯片热点密度持续攀升」这句话落到物理上经不起拆,它是卖方叙事,不是定律。
下面把我的理解一层层摊开。涉及的公司和术语,第一次出现时都会说清楚是做什么的。
一、先补一层底:AI 为什么非得用水冷
讨论冷板之前,得先把「为什么非液冷不可」讲清楚,不然后面全是空的。
看 AI 机柜功率这条曲线。传统数据中心机柜 5–10kW;英伟达 GB300(Blackwell 系列机柜)约 120kW;下一代 Rubin NVL144 约 250kW;2027 年 Rubin Ultra NVL576 直接到 600kW。四年涨十倍。
风冷扛不住,原因在流体本身。同样搬走 1kW 热量、允许温升 10℃ 这个条件下做个对比:空气需要约 302 立方米/小时,水只需要约 86 升/小时——体积差约 3500 倍。
翻译成能想象的画面:一边是每小时往机房灌 300 立方米的风(相当于一套三居室整屋空气每半分钟换一遍,而且是狂风级风速),一边是每分钟流 1.4 升的水(一个半大瓶矿泉水)。风冷不是物理上做不到,是要把机房变成风洞:送风通道占掉大半空间、风机噪音上百 dB、风机本身耗的电比搬走的热还多。
液冷不是「升级选项」,是功率到这个量级之后的唯一解。所以这条链的确定性来自 AI 算力本身的扩张,不来自某家公司的订单——这也是它能被长期跟踪的前提。 |
二、第一句:热点密度,不必然持续攀升
AVC 判断的起点是「单芯片功耗奔 4kW、局部热流密度逼近 7W/mm²(即 700W/cm²)」。热流密度,就是一块固定大小的芯片上压了多少热——分子是功耗,分母是面积。这个分数会不会一直涨,取决于分子和分母各自怎么动。先建立两个图像。
图像一:单颗大芯片,是光刻机一次能印的最大一张「瓷砖」。ASML 的 EUV(极紫外光刻机,目前最先进的光刻设备)单次最大曝光场是 26×33mm,约 858mm²。扣掉划片道和封装保护环,实际可用约 800mm² 出头——上一代 H100 的 814mm² 已经贴着这层天花板。瓷砖尺寸被打印机锁死,做不大。
关键在于英伟达是主动把 Rubin(继 Blackwell 之后的新一代 GPU)的两颗计算裸片顶在这层天花板上的:既为了塞算力,也为了摊热。它没有动力把裸片做小——做小了,同样的热压在更小面积上,热流密度反而更高、更难散。所以分母这一项,基本是厂商主动选的常数。
图像二:瓷砖上压多少热,是芯片厂自己拧的旋钮。动态功耗大致是 P = C·V²·f·α 这个结构——C(电容,由工艺决定,越先进越省电)只是其中一项,频率 f、电压 V、激活率 α、以及机柜层面堆多少颗裸片(NVL 机柜形态从 72 卡扩到 144、576 卡),全是可以自由拧的量。最贵的是电压:V 每提一点,这一项按平方涨。
所以同一代工艺,把频率拉高、电压抬一点,TDP(热设计功耗)照样往上爬,根本不需要新制程。Rubin 实际用的是 N3P(3nm 级)而不是 2nm——等于故意留了一档效率红利没用,再把这份红利花在峰值算力上。
数字摆出来就踏实了:H100 那代 700W 摊在 814mm² 上,裸片平均约 86 W/cm²;Rubin 2300W 顶在同样的天花板附近,平均约 130–150 W/cm²。所谓 700 W/cm²,是芯片一角的瞬时设计值,不是整片平均。拿一角最热当「持续攀升」的证据,叙事就夸了。 |
更直白地说:GAA(环绕栅极晶体管,新一代晶体管结构)带来的每瓦性能提升,本来可以把峰值曲线压平,英伟达选了「不压」,把红利投进峰值算力。热流密度攀升 = 选了性能优先路线,是设计选择,不是物理在逼。
三、第二句:真正被卡住的,是华为不是英伟达
换到华为,问题性质整个变了。
昇腾锁在中芯国际 N+2(SMIC N+2,约 7nm 级)工艺上,单颗算力不够,只能靠 Chiplet(芯粒——把大芯片拆成小模块再封到一起)、多颗裸片、CloudMatrix 384(华为的 384 卡超节点,用集群数量补单卡性能)去凑。结果是热源被埋进了 interposer(中介层,多颗裸片之间的连接基板)、HBM(高带宽内存)、下层裸片之下。
画个能想象的场景:像一摞锅里最底下那口在烧,热量得先穿过上面几层才能到表面。而中间隔的是什么——underfill(底部填充胶,导热系数约 1–2.5 W/mK,比铜低两个数量级)、low-k(低介电绝缘材料)、硅中介层。这些全是「隔热夹层」。热量要先爬过这一摞隔热层,才到 lid(顶盖),冷板才贴得上。
冷板厂管不到这一段。冷板的边界在盖之外——芯片封装好、盖盖好,它才贴上去搬表面热量。而垂直方向把热从裸片内部引到表面,要穿的是 low-k / underfill / 中介层 / TIM(导热界面材料,裸片与盖之间的导热介质)/ lid,全在盖之下、封装与裸片内部。
裸片内部的垂直热引出,本质是华为(制程受限、被迫空间折叠)的结构性难题,不是英伟达的主要矛盾。这条链真正的业主是封测厂(日月光、长电科技、盛合晶微)加材料厂(金刚石铜等先进导热材料),再加 3D 封装热协同设计方——不是冷板厂。 |
那冷却液能不能再往里推、直接贴到热源上?把「离热源多近」按风险层级往下排,画面是这样:
越往下越近,但风险在最后那档突变了。前四档任何一档冷却回路失效(漏、堵、蚀),后果只是热路径退化或废掉封装,计算裸片是可分离单元,换掉就行。裸片内微通道里,冷却回路和计算裸片是同一块硅——堵一处就局部热失控把裸片烧死,针孔漏就是冷却液直接上电路瞬时短路。这里没有「换冷板」这一步,失效的那个东西和计算的那个东西是同一个物体。
换个说法更清楚:前四档的故障模式是「散热变差」,最后一档是「芯片没了」。一颗裸片几千美元、良率受限,这种故障类型量产上接不住。
工程上还有两道硬卡:一是接近度容差——流道壁和有源晶体管只隔一层亚微米级介质膜,允许的机械与热扰动窗口也在亚微米级,任何蚀刻偏差、任何颗粒、任何热循环应力,都会推 Vt(晶体管阈值电压)漂移或直接短路;而嵌入式和背面这两档,同类缺陷只伤封装或背面硅,正面器件层(最值钱那层)不动,误差预算隔了一层。二是工艺冲突——晶圆级高深宽比流道蚀刻加背面密封,要和 nano-TSV、BEOL(后段金属互连工艺)共存,直接撞逻辑代工厂自己的集成流程和热预算。不是「光刻机做不了」(图形能画),是这一步不该进器件晶圆的产线。
所以能落地的近结冷却,停在嵌入式 + 背面这两档:够近,且裸片仍可分离。裸片内那一档,留在实验室。
四、第三句:钱正从冷板,搬到 CDU
这是全篇对投资者最有用的一句。先看 AVC 八条判断里最硬的那条——微通道的水力困境(Micro-Hydraulic Dilemma)。
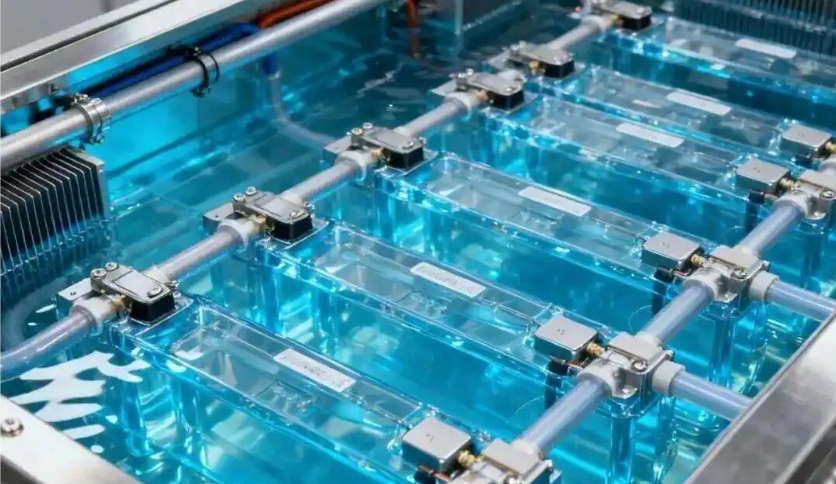
把微通道冷板想象成一块排了几百根极细吸管的散热片,水流过这些细管把热量带走。管子越细,总散热面积越大、贴着水的壁越多,换热越好——和散热片的鳍片(fin,就是那些薄薄的散热齿)越密越好是同一回事,直觉上「越细越凉」。
但「细」有个看不见的天花板。管子越细,水被挤在越窄的缝里走,压力飙升,而且不是温柔地升——缝收窄一半,压力大致按三次方到四次方往上炸。原因是双重的:缝窄了水本身得更使劲挤(压力随缝宽平方级涨),同时为了把同样多的总水量送过去,每根管里流速还得加快(速度随缝宽反比涨),两个效应叠起来,压力对缝宽是高次幂关系。
一句话:换热只随缝宽线性变好,压降却按高次幂恶化。越细,性价比越崩。
到这里还只是纸面账。真正卡死「细」的,是它牵出来的连锁:压降上去,泵就得给更高扬程,而泵功 = 压降 × 流量,泵本身装在机柜里、自己也在发热——为压住压降多花的泵功,会变成机柜里新增的一份热,这份热又得靠同一套冷却带走,于是要加大流量、压降再涨。这是个自噬的环:越努力散热,越制造热。
更麻烦的是,「变细」不是只从压降一个方向捅这一刀,它是从三个方向同时推同一个泵。这三条不是并列的三个毛病,是同一条因果链上的三段:
一是均流——几百根并联细管,制造公差让某根偏窄、流量偏少、它先热;而单根没法单独调,只能靠整体加大总流量去兜底。总流量一涨,压降按更高次幂跟着涨。
二是堵塞——流道越细越怕更小的颗粒,80–100μm 的缝要配 25μm 过滤加 0.2μm 旁路,而过滤器本身就是个压降源,等于在泵头上又加一道负担;一旦局部堵上,通道更窄、压降继续爬。
三是两相诱导——前两条把泵功推到某个点,单相水这条路上能耗已经不划算,被迫改走两相(让冷却液在流道里沸腾,用相变吸热把流量与温升解耦)。
前两条是往泵功这个方向继续加码,第三条是被逼出来的出口——它跳出了泵功陷阱,但出口外面是另一片沼泽:流量失稳、局部干涸、控制难度陡增。所以鳍片细到某个点,经济上先崩(泵功吃掉冷量),工程上再崩(三条路同时失稳)。
这恰是冷板厂的软肋、CDU 厂的机会。流道越细,冷板本身越像个被蚀刻出来的被动换热器(精度交给半导体工艺,机械厂没什么可卷的),真正的负担整个甩给了 CDU(Coolant Distribution Unit,冷量分配单元——液冷系统的「水泵 + 换热 + 控制」心脏):泵要同时给更高流量和更高扬程,电机几倍涨,分水集流管(manifold)与快接头的承压等级、泄漏风险也跟着爬。物理把冷板做成大宗件,把价值推到 CDU。 |
顺带带出一条此前没人当回事的新赛道:洁净度。微通道细到 80–100μm,比一根头发丝(约 70μm)还要细。这个尺度下,金属碎屑、非金属颗粒、甚至冷却液里养出来的生物膜,都能桥接、堵死流道——堵塞从「水处理问题」升级成「GPU 可靠性指标」。谷歌 Deschutes(谷歌数据中心液冷规范的代次)五代已经加了 0.2μm 旁路过滤。AVC 在会上公开呼吁立颗粒度标准。而标准未定,就等于新一轮生态锁定位——这是大陆厂在这条链上为数不多还能抢的位置。
还有一条最反直觉的:微通道冷板(MLCP)的主流工艺是半导体级蚀刻,不是焊接。传统大冷板是两片冲压金属板钎焊在一起;微通道细到 80–100μm,已经不是「焊两片板」能做的尺度,得用做芯片的办法——先光刻画出图形、再化学蚀刻出流道。2026 年这条工艺占比约 75%。
等于这块零件从「钣金焊接」跨进了「芯片制造」的工厂:不同的设备、不同的洁净室、不同的蚀刻液环保处理。
五、谁会掉队,谁走在了对的路上
说明:以下出现的公司名称,是从技术路线推演出的产业位置判断,用来说明「钱可能流向哪个环节」,不代表这些公司具备投资价值,不构成任何推荐。产能、良率、订单以公司公告为准。 |
工艺跨代这一刀,把一批宣称有冷板交付能力的大陆厂打了个措手不及。这 14 家是:立敏达、比亚迪电子、鸿富瀚、曙光数创、岚瑞、立讯、瑞声、蓝思、思泉、华研、同裕、莹帆、科发盛、高昱。
它们的真空钎焊炉,是为「钣金焊接」那一代准备的。在 MLCP 面前,这些产能的价值约等于零——不是要升级设备,是要换一套完全不相关的能力。
反倒是另一批名字走在了对的工艺路线上,而且这几家和冷板厂不是一个出身:
思泉新材——做石墨 / 石墨烯散热材料,石墨烯涂层已过英伟达实验室认证,而这层涂层正是微通道抗腐蚀、抗生物膜的关键。
中石科技——做导热界面与纳米碳涂层材料,纳米碳涂层被写进了英伟达硬件规范。
胜宏科技——PCB(印制电路板)出身,做的是微通道载体,等于把流道做进板级 / 基板级,正对嵌入式封装级微通道那条路。
宁波精达——精密成形装备厂,把冲压与蚀刻做成闭环,卖的是「冲压 + 蚀刻」这条微通道产线本身。
四家的共同点:都不是靠钎焊炉起家的冷板厂,而是带着涂层材料、板级载体、蚀刻产线能力,从侧面切进来的。
还有一层容易被忽略:价值量 × 良率才是利润,不是价值量本身。券商口径里 MLCP 单价是现有冷板的 3–5 倍,冷板成了价值量最大的单一环节。但看实际报表:曙光数创(A 股数据中心液冷)冷板收入 2.085 亿元、同比 +290%,毛利率只有 8.43%;鸿富瀚(301086,消费电子件转型液冷)散热业务毛利率 23.32%。用 3–5 倍单价直接推利润,会系统性高估——除非良率先过 80% 门槛,而台系自己都还没稳。
六、三条链,钱分别往哪走
英伟达链:表面冷板 + CDU 缩放 + 过滤可靠性,Rubin 代际吃 MLCP 蚀刻微通道。台系主导——讯强(Cooler Master 酷冷至尊体系,GB300 冷板份额超 55%)、健策精密(Jentech,走冲压一次成型冷板)、双鸿(Auras,做激光微加工)、AVC 走整机柜系统位;大陆是点状突破——立敏达(领益旗下,Rubin 分水集流管的大陆供应商)、英维克与高澜股份(A 股液冷,已拿到英伟达 CDU 相关认证)。侧翼打 CDU 的窗口 1–2 年,且只对已经拿到认证位次的玩家开放。
华为链:空间折叠带来裸片级近结刚需,嵌入式微通道 + 先进 TIM + 3D 封装热协同。解题方是封测厂(长电科技、盛合晶微)加材料厂(金刚石铜,代表是长沙升华、国机精工)。上面那 14 家表面冷板厂在这条线上基本没有位置——这是照着英伟达范式分析两条链时,容易漏掉的半边。
国产存量波峰:AI 芯片不是只有一条功率路线。昇腾 950DT(目标约 600W,未官宣)根本不需要 7W/mm² 级的微通道;英伟达 GB200 / 300 存量仍在两班倒。吃产能就够了,「吃存量 + 吃国产」的判断不变——变的是能不能接上下一代 Rubin,不是现在活不活得下去。
七、判断怎么被验证
这些判断最终要回到财报上被证实或证伪。三个窗口足够:
认证位次。RVL(Recommended Vendor List,英伟达推荐供应商清单)是这条链真正的入场券。没有位次,产能再大也只是接存量。窗口只对已有位次者开放。
良率门槛。MLCP 量产良率过不了 80%,单价的倍数就只是纸面数字。这条比「拿到多少订单」更能分辨真假。
订单—收入时差。这条链最大的认知差在这里:拿到订单到确认收入之间隔着产能爬坡与良率验证。财报里真正该看的是发出商品、合同资产、合同负债这几个科目的转化速度,而不是公告里的订单金额。
八、产业链判断
① 门槛是半导体工艺加系统可靠性,不是谁会造冷板。那 14 家大陆冷板厂多数接不住 Rubin 代际;走在正确工艺路线上的,是带着涂层 / 载体 / 蚀刻能力从侧面切入的公司。 ② 热点密度持续攀升要打折,而且两条链结论相反。英伟达链是设计选择、能被制程红利压住,表面冷板加 CDU 够用;华为链是空间折叠的结构性结果、压不住,裸片级近结才是真刚需。 ③ 钱往系统级位次和材料位走,不在单一冷板制造。只盯冷板份额,会漏掉真正的价值迁移。 |
还有七个实证缺口,得等一手数据补:AVC 原话是否被转述夸大、Rubin 真实裸片级峰值、BSPDN(背面供电,把供电层移到芯片背面)薄化后热阻退化量级、昇腾 970 的裸片级近结方案、AVC 整机柜订单实证、侵蚀(Erosion)量产数据、大陆第一条半导体级蚀刻冷板产线。判断先立住,数据到了再调。
来源:热能工匠
专心 专业 专注

【免责声明】文章为作者独立观点,不代表旺材芯片立场。如因作品内容、版权等存在问题,请于本文刊发30日内联系旺材芯片进行删除或洽谈版权使用事宜。邮箱liyan.ma@51wctt.com。电话:13671560361线上广告合作:17301750044