
 五度妙笔
 企业透视镜
 API商城

 数据库
卡死先进制程?华为:那行!我把 100 万颗芯片连成“一个脑子”!
2026年9月的上海,黄浦江畔的空气里弥漫着一种奇妙的狂热。
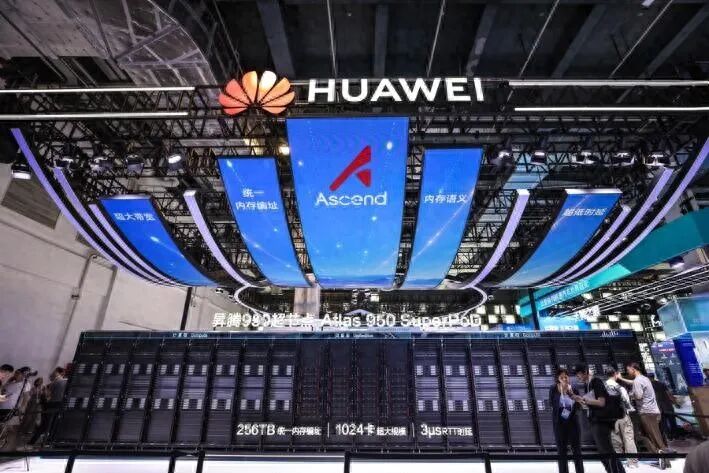
在华为全联接大会的现场,一个足以载入计算机史册的发布被扔进了AI圈:华为正式推出面向AI时代的全新计算架构——Peerium。
这项技术宣称做成了一件听起来近乎科幻的事:
打破统治计算机80年的冯·诺依曼单机限制,将100万颗处理器连接起来,作为“一台计算机”协同工作。
与此同时,产业界正上演着一幕极具讽刺意味的戏码:西方设想中“只能作为低价劣质替代品”的国产AI芯片,在市场上被大模型巨头们疯狂抢购。
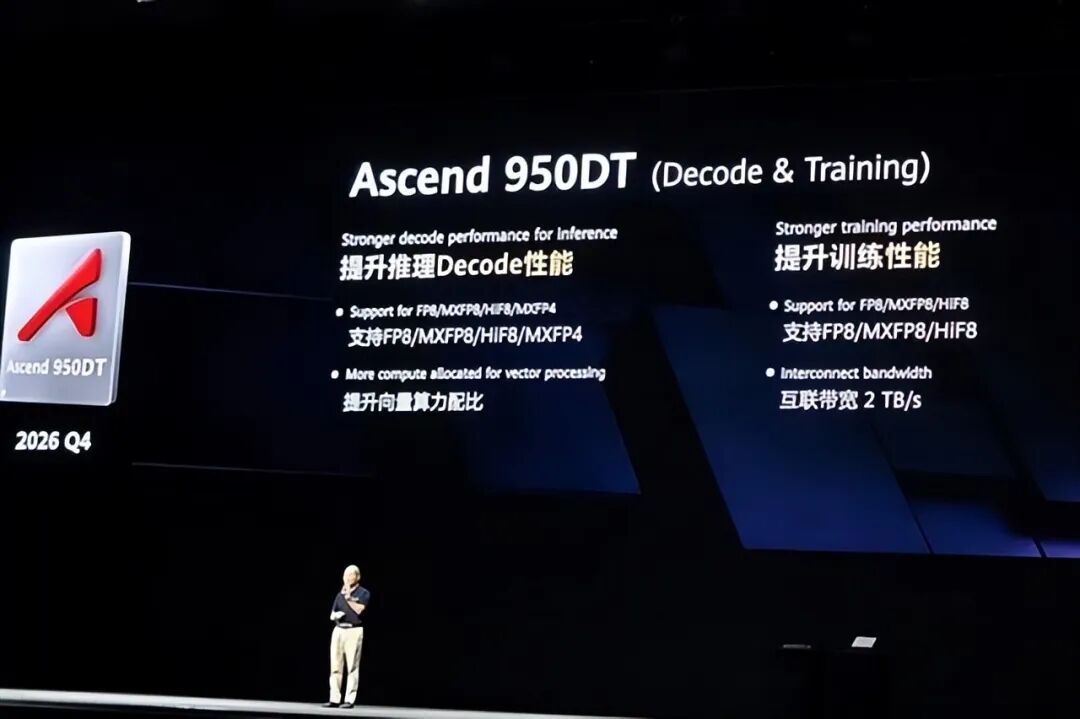
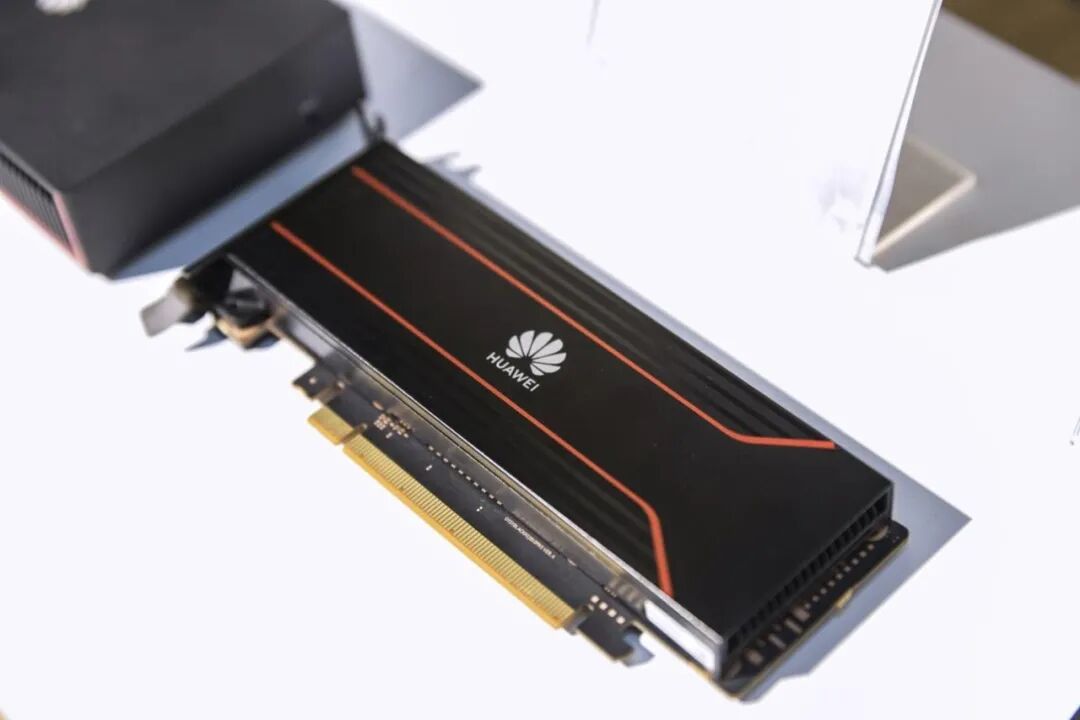
顶级AI加速卡昇腾 950DT 的单卡指导价被一路推上 25万元人民币以上,溢价逼近英伟达最顶级的 Blackwell 架构芯片,且有钱也抢不到现货。
一边是先进制程的铁幕严丝合缝,另一边却是国产算力卡横扫市场的暴利与缺货。这一切的底层逻辑,并不是我们在物理制程上实现了“一夜弯道超车”,而是一场由华为发起的、用系统工程对物理极限实施的“维度打击”。
01 80年的计算机“死结”:100万人的“群聊瘫痪”
要看懂 Peerium 架构的颠覆性,得先看看西方原本为中国半导体设下的“物理死局”。
过去几年,西方封锁的核心逻辑简单粗暴:限制台积电代工 3nm/2nm 先进制程,不给高端光刻机。按照传统逻辑,单颗芯片上的晶体管数量被锁死,单卡算力就上不去;单卡算力不行,中国大模型训练就必然在物理墙面前撞得头破血流。
但这招能生效的前提,是世界必须继续沿着“单机堆晶体管”和“传统主从集群”的老路走下去。
传统的计算机世界建立在冯·诺依曼体系和图灵范式上,不仅单机存在数据在CPU和内存间搬运的“内存墙”,当上万张算力卡拼成大集群时,更会遭遇可怕的“通信墙”。
传统集群是主从架构(Master-Slave)——由一个“主节点”负责分配任务,成千上万个“从节点”干活。这就像建立了一个 100 万人的微信群,1 个群主(主节点)要给 100 万个组员(从节点)发指令、收作业。
结果是什么?
组员还没开始干活,群主的手机就已经爆内存卡死了;
更绝望的是齐步走(标准BSP范式): 传统并行要求 100 万个人拧完螺丝后,必须同时站起来报数,只有等最后一个人报完,大家才能拧下一颗。
哪怕只有一张显卡因为发热抖了一下、卡顿了 0.1 秒,另外 999,999 张卡就得全部原地发呆。当集群扩展到十万卡甚至百万卡级别时,有效算力效率(Goodput)会呈断崖式下跌,甚至降到不到 30%。
西方赌的,就是中国芯片在大规模组网时会死于这套“群聊瘫痪”的古老诅咒。
02 Peerium 的升维反击:去特么的“主从关系”,大家都是“自己人”
既然单颗芯片堆晶体管被掐住了脖子,华为的选择是:我不跟你卷单芯物理节点了,我重写大规模计算的物理规则。
Peerium 架构的底层精髓,一言以蔽之:终结主从,平等互联。
华为用三大技术干掉了统治行业几十年的旧秩序:
灵衢(Lingqu)总线:硬件世界的“开放通信”
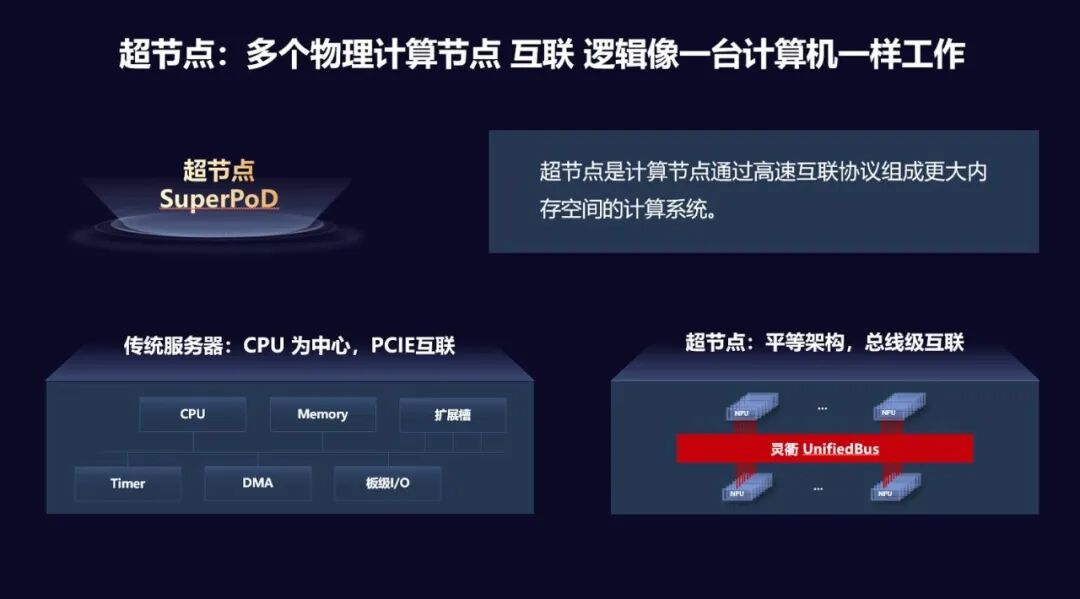
以前 CPU、NPU(昇腾)、内存、SSD、网卡都有各自的语言和“尊卑贵贱”。华为用统一的灵衢开放总线协议,把十余种复杂协议归一,让所有硬件在总线上地位完全平等。
互联带宽直接拉到 TB 级,通信时延从 7 微秒骤降至 2 微秒。CPU 想看 NPU 里的数据,或者 NPU 想读另一台机器上的内存,像读取本地缓存一样快。
统一内存寻址:把百万芯片变成同一个“超大池子”
在 Peerium 的世界里,100 万颗处理器不再是分布在成千上万台服务器里的“独立个体”,它们的内存被编入同一个地址簿(全局内存统一编址)。
对程序员来说,再也不用痛苦地写代码去协调 10 万台机器怎么发信件,这 100 万颗芯片在逻辑上,就是他们面前同一台装了无穷大内存的“超级单机”。
Nested BSP(嵌套并行):造航母级别的“分级管理”
华为抛弃了强制百万卡齐步走的愚蠢模式。 Nested BSP 允许小组内部自己报数、车间管车间、工厂管工厂。
小组内部异步迭代,工厂之间分层同步,彻底解决了“一张卡发热卡顿,整个国家级超算陪着干等”的致命硬伤。
你掐我单颗芯片的晶体管密度,我就用全新架构把 100 万颗芯片拧成同一个大脑。在系统工程面前,单纯的单芯制程封锁,变成了降维打击下的无效动作。
03 25万一张卡凭什么被抢爆?大模型厂商的“真香法则”
如果说 Peerium 是宏大的技术叙事,那市场给出的反馈就是冰冷而血腥的商业现实。
在芯片市场,“爱国情怀”可以买单一次,但支撑不起连续飙升的溢价。昇腾 950DT 价格破 25 万元人民币依然抢不到手,其根本原因在于大模型厂商算清了一笔账:计算效率(Goodput)才是 AI 时代的终极血线。
外企为了合规推出的“特供版”芯片(如 H20),虽然单芯名义指标尚可,但其互联带宽被割了关键一刀。这就像买了一辆最高时速限制在 80km/h 的豪车,单看车标挺美,可一旦几千辆组队开上高速,瞬间堵成一团乱麻。
相反,华为部署的 Atlas 950 超节点(25.6万卡规模已在运行)以及基于 NPO(共封装光学)技术的 Atlas 960 系统,展现出了恐怖的工程落地能力:
1)甩掉 4 万多颗光模块: Atlas 960 用 5,500 个 NPO 光引擎替代了传统机柜所需的 4.8 万颗 800G 光模块。零部件数量呈数量级下降,意味着引发集群故障的概率直线下滑,集群可用度拉到了 99.8%。
2)省出一个小镇的电费: 光是 NPO 带来的功耗降低,就高达 550 千瓦。在万亿参数大模型训练动辄烧掉数千万电费的今天,省下来的电都是纯利润。
在大模型厂商眼里,买一张 25 万的昇腾 950DT,买的不是一块硅片,而是一张“保证几万卡连续跑一个月不崩溃、不丢进度断点”的通关文牒。相比之下,那些看起来名头响亮、实则集群通信卡顿的芯片,送给大模型厂商都是在浪费他们的电费和研发生命。
04 从“拼晶体管”到“造超级大脑”:半导体百年战局的“升维时刻”
跳出这场发布会,站在更宏大的历史坐标系来看,华为 Peerium 的推出,标志着半导体产业的竞争游戏规则彻底变了。
自 1965 年摩尔定律提出以来,半导体巨头们陷入了一种“晶体管教条”——把晶体管越做越小,从 28nm 到 3nm,似乎这就是计算科学的唯一正道。
然而,物理学的底线终究无法突破,量子隧穿效应和硅基材料的散热极限已经逼近。
而华为这场架构革命宣告了一个新时代的到来:后摩尔时代,计算力的爆发点不再是晶圆厂里的微米级较量,而是系统工程的架构级重构。
更深远的局面上,这还是“封闭苹果范式”与“开放安卓范式”的终极对决。
英伟达依靠 NVLink 封闭总线和 CUDA 垄断壁垒,建起了一座高墙耸立的封闭帝国。而华为推出的灵衢总线和 Peerium 架构,却选择完全开放协议,允许全球第三方芯片、内存和存储厂商自由接入。
当对方还在玩“单兵作战”的时候,华为已经在搭一个开放的“万国联合舰队”。
这一枪打响后,西方砸下数千亿美金构建的制程围墙,突然显得有些尴尬。他们花了五年时间试图把中国 AI 芯片卡死在单机性能的天花板上,却没想到中国厂商直接把天花板掀了,把整个屋顶改成了通往天际的发射台。
打不死你的,终究会逼你进化成他完全看不懂的样子。当物理世界的光刻机被戴上枷锁,天才的工程师们便在数学与架构的荒原上,徒手凿出了另一条通往星辰大海的公路。
现在,25万一张的卡依然在市场上被疯狂争抢,百万颗芯片组成的“超级大脑”已经在算力中心里发出轰鸣。物理封锁的栅栏还在,但围栏里困住的,究竟是谁呢?


