
 五度妙笔
 企业透视镜
 API商城

 数据库
RK3588原生算力不够,多路AI视觉只能减摄像头?XC3588E+算力加速卡给出新解法
做边缘
AI
项目,你是否遇到过这样的困境:
前期选型RK3588平台,凭借6TOPS原生NPU算力,顺利完成原型开发。项目落地量产、模型迭代升级后,算力瓶颈突然显现——多路IPC、工业相机同时做目标检测、缺陷识别,画面帧率暴跌,推理延迟飙升。
想保证识别效果,只能削减摄像头接入路数;如果不减少路数,要么迁移到价格昂贵的海外算力平台,要么把视频流上传云端做AI分析。但上云方案的弊端同样突出:持续产生高昂带宽费用,网络波动就会导致识别失效,一旦断网整套AI系统直接瘫痪。难道算力不足,就只能二选一:减通道,或是整套硬件推倒重来改版?
向成电子
XC3588E智能主板+DEEPX算力加速卡
,带来
弹性异构算力扩容方案
,
全部采用全新原装芯片,
不用更换原有主控主板,底板、固件、业务代码可最大程度复用。
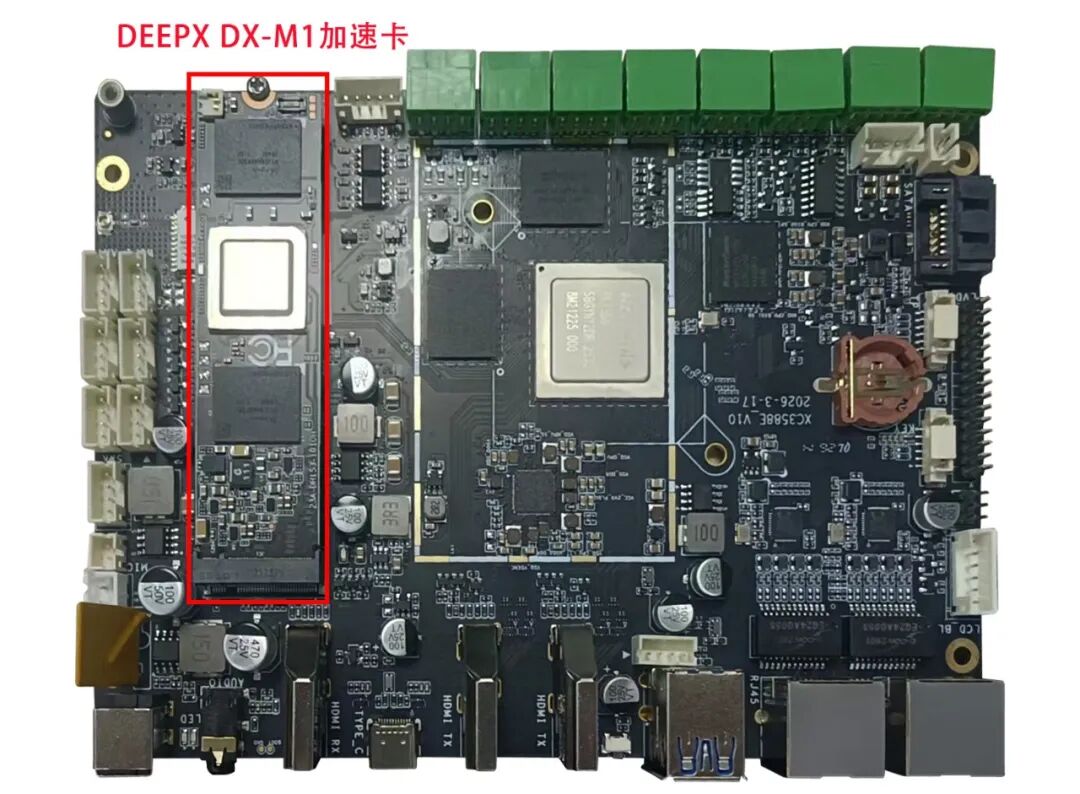
XC3588E基于RK3588主控,本身自带6TOPS NPU算力,可独立承载轻量级AI识别任务。主板预留
M.2扩展
接口
,可直接插接算力加速卡
(
25TOPS NPU算力)
,
叠加后整机异构算力大幅提升。轻量推理交给主板原生NPU,多路视频分析、
高精度
质检、端侧大模型这类重型推理任务交由加速卡承载,算力分工并行,解决多路视觉并发卡顿难题。
这套方案最大优势在于
项目算力按需升级
。产品初期业务简单,只用XC3588E主板即可交付;后续需求升级、AI模型迭代,无需重新设计
PCB
、更换整机硬件,直接加装算力加速卡完成算力扩容。大幅缩短项目二次开发周期,控制研发与库存成本。
硬件层面,XC3588E作为工业级智能主板,
采用全新原装芯片,
具备工业宽温能力,7×24小时不间断稳定运行;配备丰富工业接口,6路串口、
9路
USB
、双
CAN
接口、带
HDMI
IN/OUT、双千兆网络、GPIO等,可直接对接工业相机、
传感器
、显示终端,适配各类现场设备集成。软件生态上,原生支持Ubuntu、安卓、银河麒麟等系统,模型迁移便捷,国产硬件底座满足众多行业自主可控需求。
典型落地场景
工业视觉:
产线多相机缺陷检测、产品外观质检
智慧安防/园区:
多路摄像头人形、烟火、入侵识别
能源电力:
变电站、光伏场站巡检图像分析
AI机器人:
多模态视觉识别、现场环境感知
很多边缘AI项目卡在算力扩容成本高、改板周期长的痛点。XC3588E+算力加速卡,跳出“算力不足就换板”的固有思路,以可插拔式弹性算力架构,在本地完成多路AI实时推理,数据保留在边缘节点,低延迟、断网可用,兼顾性能、成本与数据安全。
摄像头
摄像头
+关注
关注
61
文章
5186
浏览量
104947
AI视觉
AI视觉
+关注
关注
0
文章
160
浏览量
5122
RK3588
RK3588
+关注
关注
8
文章
674
浏览量
8692


