
 五度妙笔
 企业透视镜
 API商城

 数据库
AI 集群里的光链路异常,问题真出在光模块吗?
9 月 15 日,Credo 发布了一款 1.6T 光模块,产品线的名字直接叫 ZeroFlap,零闪断。它摆在最前面讲的卖点不在速率上,而在一件听上去不太像光模块该操心的事:链路两端的模块都能把自己的健康状况报上来,出了问题不必派人跑到两头去查。
链路闪断,是指一根链路在几秒甚至更短的时间里断开、又自己连了回来。放在别的场景里这不算事,但训练大模型是几万块卡一起算一道题,一根链路闪一下,整批卡都可能停在那里等。
这件事有多常见,运营方自己公开过数。阿里云 2024 年发表过一篇讲 HPN(High Pe
rf
ormance Network,它为大模型训练专门搭的数据
中心
网络)的论文,里面把两件事分开记:链路故障是断了要修,闪断是自己能恢复。它在役的大模型训练集群,每月有 0.057% 的网卡到
交换机
链路发生故障,每天则有 5,000 到 60,000 次链路闪断。同一篇里还算过一笔账:三千块
GPU
的训练任务每小时成本两万美元,一旦出故障就要回滚到几小时前的检查点,一次损失约三万美元。按 0.057% 这个比例推一下,一个十万块卡的集群,光是网卡到第一层交换机这一段,一个月大约要坏 57 条链路,差不多一天两条。
Open
AI
今年 5 月和 Microsoft、
AMD
合写的一篇论文说得更直接。在一次大规模同步预训练里,交换机之间的闪断每分钟都在发生,他们的做法是让这些链路照常留在网里,靠传输协议把数据撒到别的路径上绕开,至于修它,论文说这个的优先级很低。我们此前拆过一次 AI 集群里到底用了多少光(详见GPT-6 Astra,用了多少光?),那篇停在「往后跟着翻的除了模块数量,还有对单只模块出问题概率的要求」。这一篇继续来聊一下,这些问题到底出在链路的哪一段。
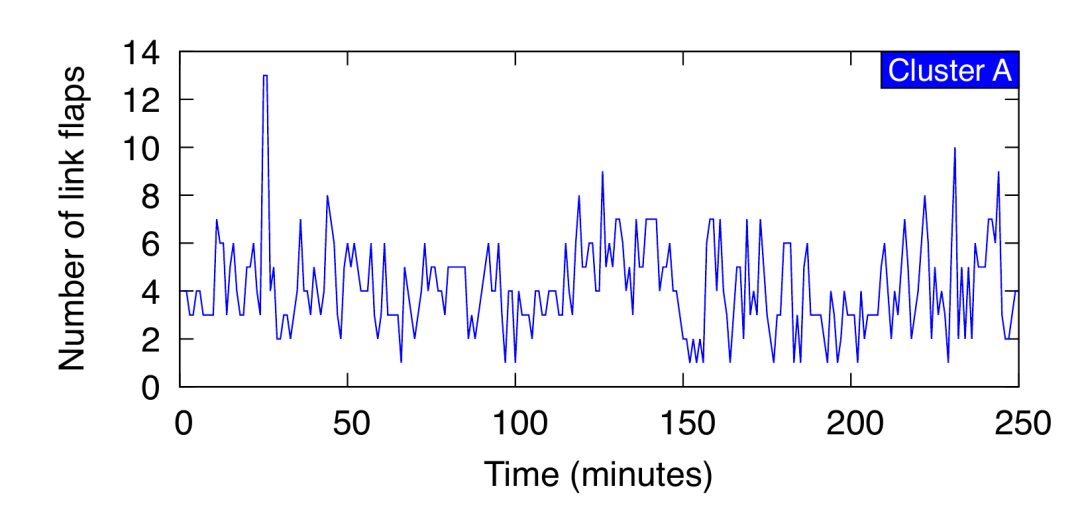
图为 OpenAI 那个集群在一次大规模预训练中,交换机之间每分钟发生的链路闪断次数,横轴是 250 分钟。图源:OpenAI 与 Microsoft、AMD 合著论文,arXiv 2605.04333。
链路出问题多半不在模块,真在模块多半是激光器
能找到的公开数据我们都翻了一遍:Microsoft 研究院曾经对 15 个在役数据中心、35 万条光链路的丢包工单统计,华为 2024 年底白皮书里的光模块失效模式分布,Cisco 今年 2 月讲 400G 到 1.6T 可插拔光模块时给的现场返修口径。年代不同,统计的东西也不同,几家的百分比没法直接摆在一起比。我们把它们折算到同一条链路上,得到这样一个分布:一条链路出一次问题,33% 是接头脏了或者没插好,28% 是光纤被弯折或损伤,23% 会怀疑是光模块的问题,剩下 16% 是分支线缆、交换机背板这类共享部件。

图为本号把三份公开材料折算到同一条链路上得到的失效分布:原始占比区间取中点后归一,模块那一格按现场返修约一半查不出毛病拆成重插与真坏两半,真坏的那半再按模块内器件失效的分布拆一次,百分比为估算值。数据来源:Microsoft 研究院 CorrOpt 论文(SIGCOMM 2017)、华为《迈向智能世界白皮书 2024·数据
通信
》、Cisco Live 技术分享 BRKOPT-2699。
接头和光纤加起来占 61%。原因论文里有一句:光纤端面对灰尘和污染的容忍度接近零。它还提到,装机前本该逐芯用显微镜检查端面,这一步因为费事,现场大多被跳过。
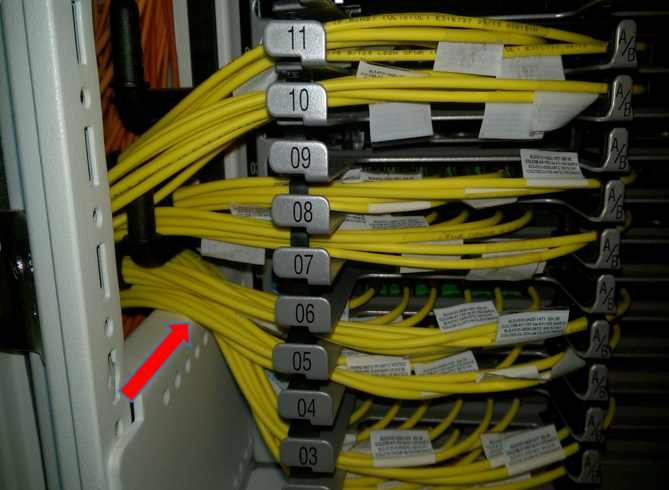
图为弯折超过最小弯曲半径的光纤跳线,红色箭头指向弯折处,这类弯折会让链路丢包。图源:Microsoft 研究院 CorrOpt 论文,SIGCOMM 2017。
被怀疑是模块问题的那 23%,Cisco 说现场返修回来的模块大约一半查不出毛病,也就是说这 23% 里有一半重新插紧就好、模块本身没事,真坏的约占全部的 11%。而模块内部的器件失效里,约 90% 与激光器有关。两步折下来,
激光器约占整条链路失效的 10%
。
模块这一侧的分量还在往上走。华为的口径里,光模块占计算节点失效部件的 23%,排在 NPU(华为昇腾这类 AI 计算芯片)前面;它给的一条解释是智算机房里光模块的运行温度比通用计算高 20 ℃。今天还多了一类 2017 年那张表上没有的根因:模块固件。Cisco 举过一个例子,同一只模块在不同的上下电周期之间,误码率能差出五个数量级,落到现场就表现为链路闪断,最后是靠改固件解决的。
所以现场面对的是这样一个局面:坏得最多的是接头和光纤,模块不是大头;但一旦真轮到模块,多半跟最贵的那颗激光器有关。任何一份统计表能给的都只是同类事件的平均长相,运维要处理的却是眼前这一条链路。
测什么早就写进了 CMIS,连激光器年龄都在里面
于是这两年出现的产品都在往同一个方向走:让每一条链路自己报出当下的状态。Credo 这款模块的新意也在这里。在说它新在哪之前,我们先看看业界普遍是怎么做的。
光模块和主机之间怎么对话,有一份公开的行业规范,叫 CMIS(Common Management Interface Specifica
ti
on,通用管理
接口
规范)。交换机或网卡怎么认出插上来的是什么模块、怎么配置它、怎么读它的状态,都按这份规范来。它由 OIF(Optical Internetworking Forum,光互联
论坛
)发布,这是运营商、设备商和芯片厂一起制定光互联技术规范的行业组织,最新的是 2024 年 9 月的 5.3 版。从 5.0 版起,CMIS 里就有一套叫 VDM(Versatile Diagnostics Monitoring,通用诊断监测)的机制,逐个通道报出链路质量。
Cisco 在那场技术分享里列过它自家模块支持的观测量,里面有激光器年龄、激光器温度、光口和电口两侧的信噪比、纠错之前的误码率,还有纠错码字的错误统计。用途也写得很具体:跟踪模块寿命、帮着安排现场更换,监控激光器温度来调风扇转速,以及靠本端收到的
信号
质量去判断对面那只模块发得好不好。
也就是说,「让模块报出健康数据」这件事本身早就有了公开规范,连激光器老化都有专门的观测量。规范定义了这些能力,至于每家模块支持到哪一步、固件和主机认不认,那是另一回事。
标准缺的两块:出事那一刻留不下来,另一头读不到
拿现场排查一次闪断来对照,就能看出标准缺在哪。运维要把一次闪断查清楚,至少得知道两件事:出事那一刻链路是什么状态,链路两头各自看到了什么。这两件事,CMIS 都没给全。
先说出事那一刻。标准里的这套监测只报「现在」,主机来读一次,数据就过去了,模块自己几乎什么都不记。可闪断常常发生在半夜、只持续几秒,等人第二天来查,现场早就没了;模块要是被拔下来换走,仅剩的那点痕迹也跟着没了。
再说链路两头。一条链路的两头往往插在不同的机器上,归不同的团队管,有时对端还是租给客户的机器,运维根本登不上去。标准只让你读自己这一头,对面发得好不好,只能靠自己这头收到的信号去猜。结果就是一条链路出了问题,常常说不清到底是哪一头、哪一段的毛病。
补这两块的,是 OCP(Open Compu
te
Project,开放计算项目)去年 12 月发的一份光模块遥测规范(0.9 版)。OCP 是 Facebook(现在的 Meta)2011 年发起的开源硬件组织,数据中心里服务器、交换机、光模块的不少公开规格都出自这里。它照测现行标准里那些量,在上面加了两件事:一是让模块把测到的数据和出过的事件都存储下来,掉电不丢,拔下来插到别的机器上也还在;二是让链路一头能直接读到另一头模块的记录,指令顺着光纤本身传过去,业内叫带内消息,不用登上对面的机器。
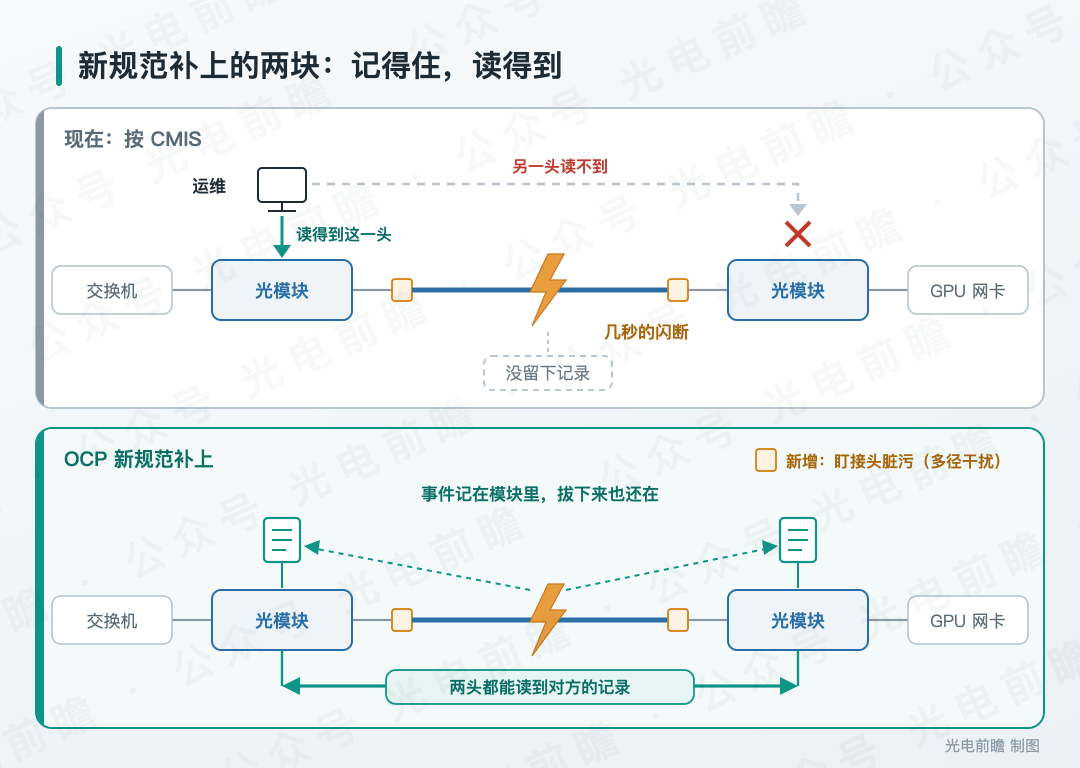
图为现行 CMIS 规范与 OCP 新遥测规范在排查闪断时的差别。数据来源:OIF-CMIS 5.3、OCP Enhanced Telemetry Optics Product Software Specification V0.9。
它还多加了一个叫「多径干扰」的指标,专门用来抓接头的毛病:接头脏了、松了,光在端面上的反射就会变强,这个指标跟着上涨。这正好对着前面分布里占比最大的那一块。Credo 也说,它的遥测能在链路真正断掉之前,看出光纤这一侧污染的迹象。
难的是把一个数字对上链路的哪一段
测出一个数不难,难的是数值异常之后,判断现场该去擦接头、换跳线,还是换模块。
粗的对照关系早就有人做过。Microsoft 那篇 2017 年的论文,除了根因占比,还给了每一类根因「最可能的症状」,判据是链路两端的发光功率和收光功率各自的高低怎么组合。两端收发都高,是接头脏了或者共享部件坏了;这一端发得高、那一端收得低,是光纤弯折或者损伤;两端都低,才轮到激光器衰退。论文里有一次真实的事故可以对照着看:有一次两端的收光功率同时掉了十几 dB,发光功率一点没变,判成光纤损伤,换掉线之后两端的收光功率一起回到正常值。
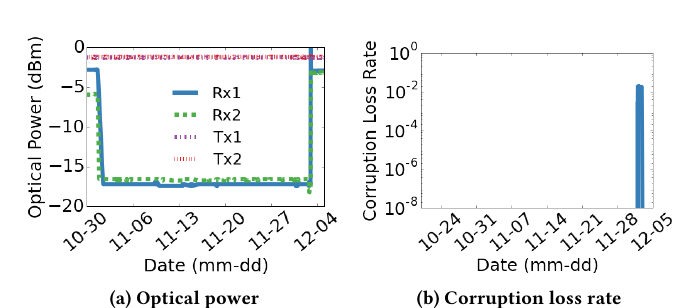
图为那次光纤损伤的全过程:左边是两端的收发光功率,两端收光功率同时掉下去、发光功率没变,换线后一起恢复;右边是同一段时间的丢包率。图源:Microsoft 研究院 CorrOpt 论文,SIGCOMM 2017。
难的是把这套做法做得更细、更早。上面那组判据要等到光功率已经掉下去、链路已经在丢包,而今天想要的是在链路还没断的时候就分辨出来。前面 Cisco 那个固件的例子说明这有多难:光看误码率这一个数,现场只会判断这条链路在恶化,而真正的根因在固件里。
Credo 自己的说法是,它把客户的设备放进温箱反复弄坏,再一条条做根因分析,用这种方式攒出「什么样的信号变化对应什么样的毛病」。
观测量是公开的,把观测量翻译成
维修
动作的那张对照表,得靠现场数据一点点堆出来。
有一点需要注意,带内消息要走得通,链路两头的模块得能「对上话」。Credo 的说法是,两只模块会互相交换序列号和链路状态。可云厂商买光模块历来是好几家同时供货,一条链路两头未必是同一家的模块,所以这套能力能覆盖多少链路,要看两头凑不凑得齐。这也是它要往规范上走的原因:写进规范,别家的模块也能照着做。
不过规范走到哪一步,看一眼署名就知道。那份 0.9 版归在 OCP 的光模块可靠性工作组名下,作者一栏只有一个人,来自 Credo;文末致谢里是 Or
ac
le 的三位和 Credo 的三位。写规范的和卖产品的还是同一家,旁边有一个云厂商,别的模块厂和别的买方都还没进来。
NVIDIA 在网络管理层,华为在端网协同,Credo 在模块里
针对这样的问题,至少有三家公开讲过自己怎么做,介入的位置各不相同。
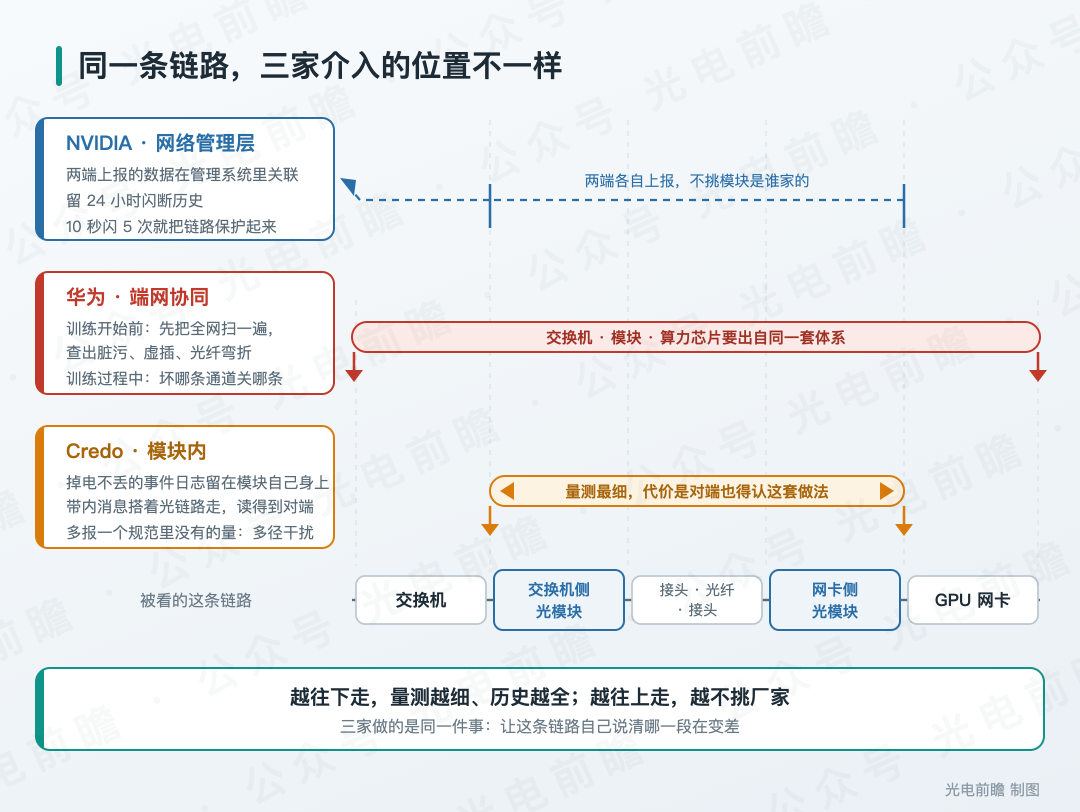
图为本号整理的三家介入位置对照:红色那条覆盖从交换机到 GPU 网卡的整条链路,橙色那条只在两只光模块之间,蓝色虚线表示两端的数据上报到管理系统。数据来源:NVIDIA 官方文档、华为《迈向智能世界白皮书 2024·数据通信》、Credo 官方新闻稿。
NVIDIA 放在网络管理层。它的线缆校验工具会校验第一层链路的完整性,包括误码率、各通道光功率和温度,识别出正在闪断的链路,把一条链路两端上报的数据关联在一起看,保留 24 小时的闪断历史,还能在一条链路 10 秒内闪 5 次时把它保护起来。数据来自两端,但汇总和判断都在管理系统里,它不挑模块是谁家的,代价是拿不到模块内部的量,也留不住事发那一刻。
华为放在端网协同。训练开始之前,让网络里的光模块发一串伪随机码流,配合 OTDR(光时域反射仪,往光纤里打光、看反射回来的信号,就能找到断点和损耗点)检测,把全网模块的脏污、虚插、光纤弯折先扫一遍,华为称这样能在训练开始前解决 70% 以上的隐患。训练过程中用的是通道级隔离,交换机、模块和 NPU 三方配合,哪条通道坏了就关掉哪条,降速但不断网,华为称这样能缓解 90% 的光模块故障。这一套能一直做到关闭单条通道,前提是网络、模块和算力芯片出自同一套体系。
Credo 放在模块和光链路本身。观测量算在自己的
DSP
里。眼图、信噪比、误码统计这些量本来就在 DSP 内部生成,自研 DSP 就比只做模块的厂家多拿到一层。历史记在模块自己身上,取数走光纤里的带内消息。这些数据最后要进哪套运维系统,取决于交换机上跑的网络
操作系统
,Credo 的软件扩展支持 SONiC 这类开放系统(SONiC 是 Microsoft 开源的交换机操作系统,现在由
Linux
基金会维护)。它量测最细、历史最全,代价是对端也得是认这套做法的模块。
光模块要改的,是能不能关掉坏掉的那条通道
AI 集群里光的可靠性,接下来更可能靠两件事解决:网络扛得住单根链路闪断,以及每一条链路能自己说清哪一段在变差。
最能说明方向的反倒是华为那一页。它明明白白写着模块失效的主因是激光器件,给出的方案却不是换一颗更耐用的激光器,而是训练前查脏污虚插、训练中关掉坏掉的通道。OpenAI 那篇论文里也有类似的一笔:他们网卡上那只 800G 模块拆成四个 200G 口用,模块本身一闪,四个口一起掉,任务扛不过去。论文写了一句换一种
光学
设计也许能整个避开,但没有说换成什么,同时也说明这类事件他们确实遇到过,只是不常见。到今天,把这个单点做进方案的只有通道级隔离一条,模块形态要怎么改,还没有人给出答案。
对做光模块的人来说,这意味着接下来要交付的东西里多了一项:模块得能把坏掉的那条通道单独关掉,还得能把自己的状态说出来,并且说得让对端和交换机都听得懂。对清洁检测、
连接器
、跳线这一格的供应商来说,端面污染从「装机前的一道工序」变成了「运行期要持续监测的量」,而这一格的活本来就随光纤根数增长(详见CIOE 2026 观察:规范今天上午才发,用它做的模块已经在展柜里了)。扩束连接器这类降低端面污染敏感度的做法,会因此更被看重(详见被低估的 CPO 量产卡点:光纤接口在「胶水永久键合」之外,多了「可拆卸」这条路)。
往后有三处可以盯:CMIS 下一版会不会也要求模块把出过的事记在自己身上,OCP 那份光模块遥测规范会不会从 0.9 版走到正式版并被别家采用,以及国内的模块厂会不会跟上这条线。阿里云在自研光模块上起步很早,它这两年的取舍值得对照着看(详见最早自研光模块的阿里,在全行业冲 CPO 量产元年时踩了刹车)。这几条线我们会持续关注,有新的进展再带回来。
AI
AI
+关注
关注
92
文章
45832
浏览量
306507
光链路
光链路
+关注
关注
0
文章
11
浏览量
11734
光模块
光模块
+关注
关注
85
文章
1909
浏览量
66524


