
 五度妙笔
 企业透视镜
 API商城

 数据库
让设备真正“听懂”你:涂鸦自研端到端流式 ASR 模型发布
在Physical
AI
的浪潮里,语音是人机交互最自然的入口。对
智能硬件
开发者
而言,一台“听得清、跟得上、叫得对名字”的设备,才是智能体验的开始。
今天,涂鸦智能正式发布自研端到端流式
语音识别
模型Nomo-ASR:它是涂鸦Physical AI 模型目录中的
音频
模型,也是自研语音系统 OmniSpeech 编排链路中的核心 ASR 能力。
在一轮覆盖 8 套中英文行业基准、3 套热词专项、流式时延与并发压测的全面横评中,Nomo-ASR 拿下了综合第一——8 套中英主测集 6 套最优(英文 3/3 全胜),企业品牌热词场景大幅领先主流云厂商。
更值得关注的是对我们的核心场景的验证:
嵌入式
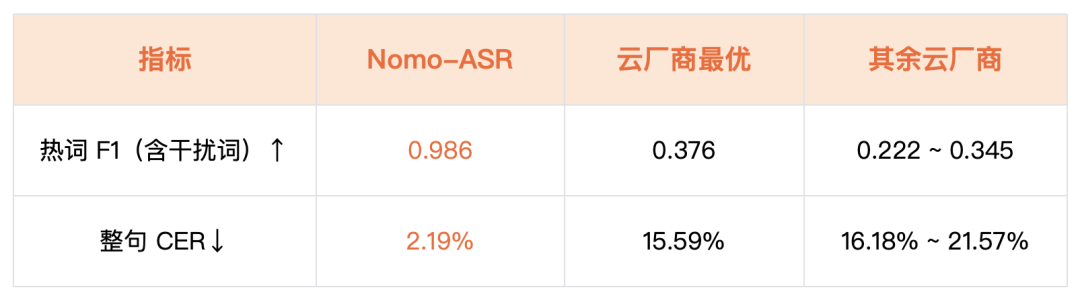
设备的真实收音。公开基准代表的是“通用场景”,而设备端麦克风收音(远场、噪声、失真、口音)才是 Nomo-ASR 从训练到优化始终围绕的主场——在设备收音测试集(1,016 条线上真实业务音频)上,Nomo-ASR 同样拿下五路最优,识别错误率相对云厂商最高降低 51%。
01
通用云ASR 解决的是“听写”,而智能终端场景要的是“听懂”:
设备控制指令:“打开次卧空调”、“关闭地暖阀”——识别错一个房间、一个设备,指令就是错的;
品牌与专有名词:TuyaOS、
HomeKit
、Mat
te
r、生僻地名、新品类名——通用模型大概率写错;
嵌入式收音质量:设备端没有录音棚。远场拾音、设备腔体与环境噪声、低成本麦克风的闷声与失真,是设备语音的常态——通用 ASR 在这类音频上普遍明显掉点;
实时性:语音交互里,每多100ms 等待,用户对“智能”的感知就淡一分;
端到端可控:识别只是链路一环,热词下发、断句、标点、数字规整需要一体化协同。
这些恰好是自研模型可以深耕的地方。Nomo-ASR 从第一天就为智能设备语音交互而设计,训练与优化始终以真实设备音频为核心——这也是它能在设备端真实收音上领先通用大模型的根本原因。
Nomo-ASR 是端到端流式识别模型:音频边收边解,在同一路双向流里先输出实时草稿(partial),每句结束再输出高质量定稿(final)。
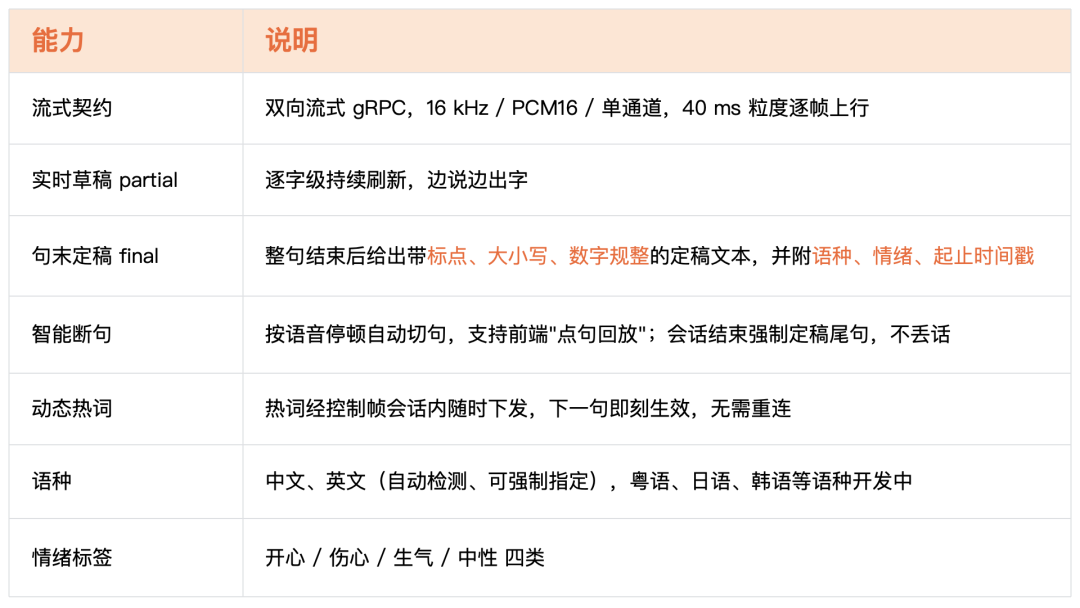
对开发者来说,这意味着两件事:
1. 延迟与质量兼得——用户先看到逐字刷新的实时字幕,几百毫秒后同一句被更优的定稿替换,标点、大小写、数字一步到位;
2. 协议足够简洁——上行只有config / audio / control三种帧,下行只有sentence / done / error;Sentence.stable一个字段区分草稿与定稿,SET_HOTWORDS下一句生效,END强制定稿。半天即可完成接入。
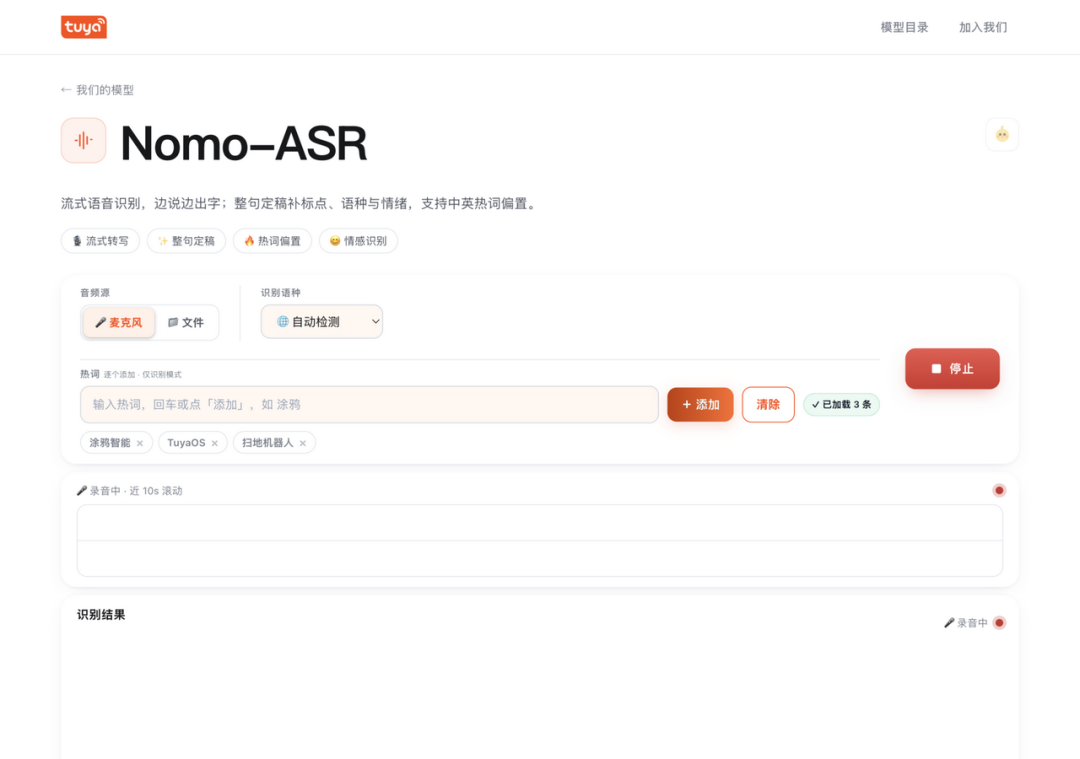
▲ Nomo-ASR 在线 Demo 实拍:麦克风/文件双输入,热词即加即用(图中已加载“涂鸦智能 / TuyaOS / 扫地
机器人
”),定稿句自带语种、情绪徽章,热词命中高亮,支持点句回放。
03
成绩单:8 套中英基准,6 套最优
我们将Nomo-ASR 与四家主流云厂商的在售商用ASR A
PI
(下称厂商A/B/C/D,均为各自推荐配置)在统一口径下横评,覆盖朗读、方言、网络口语、众包、多域口语等公开基准,以及涂鸦线上真实业务语音:
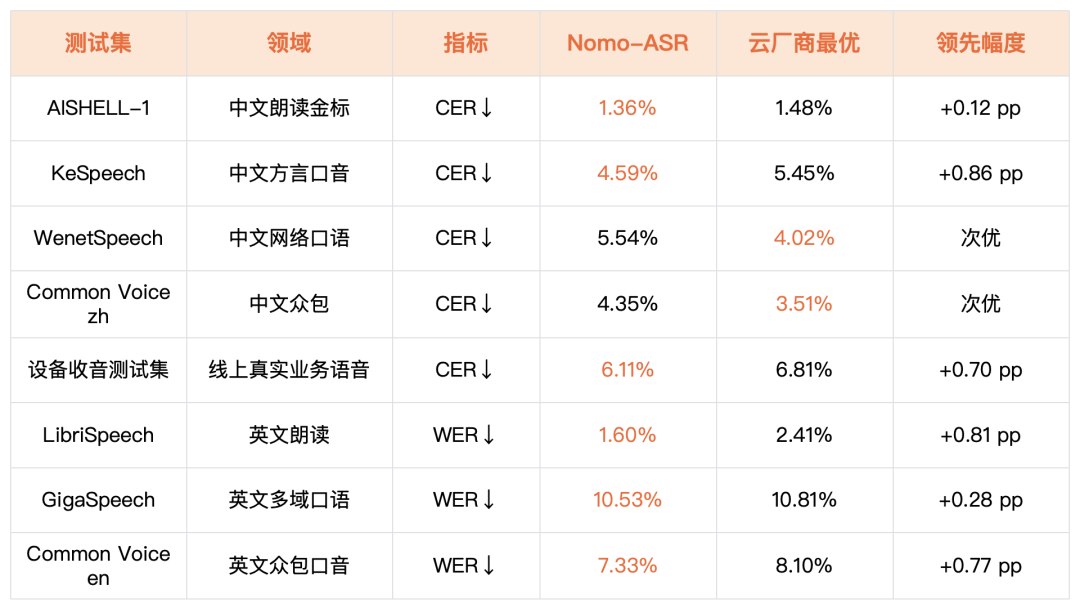
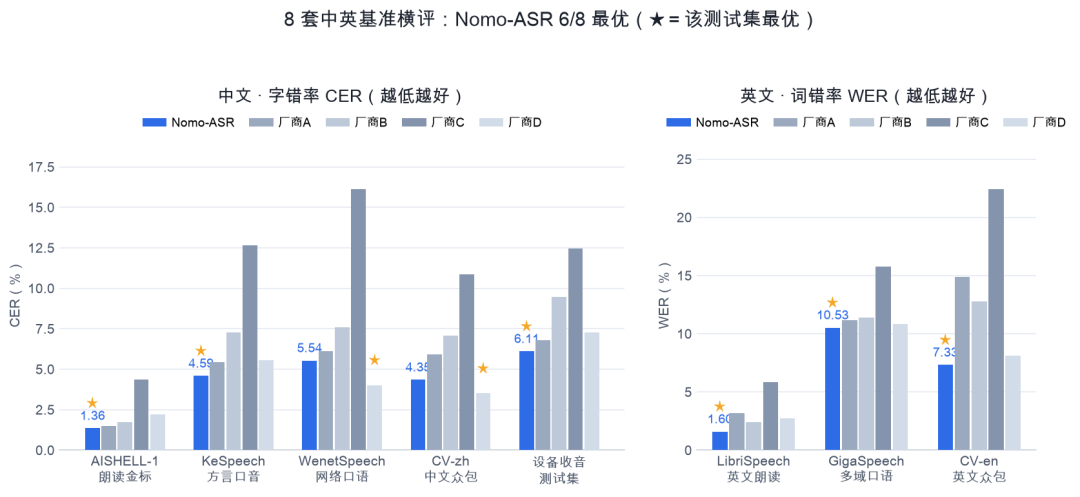
▲ 8 套中英基准横评(★=该测试集最优;Nomo-ASR 6/8 最优,WenetSpeech 与 CV-zh 两套由厂商 D 反超,如实呈现)
核心场景:嵌入式设备真实收音,第一
如果只看一张图,我们建议看这张——设备收音测试集:1,016 条来自涂鸦线上业务的真实音频,含设备端麦克风的远场拾音、环境噪声与真实口音,是离用户体感最近的一套金标。

▲ 设备收音测试集(1,016 条线上真实业务音频):Nomo-ASR 6.11%,五路最优
差距比看上去更大——把 CER 换算成识别错误率的相对降幅:
相对四家云厂商中的三家,Nomo-ASR 的识别错误率降低16% ~ 51%(对厂商B 降低 35.4%,对厂商 C 降低 51.0%);
即便对阵排名最高的厂商A,错误率也相对降低10.3%——在 6% 出头的绝对值上,每 10 个错误里少错 1 个,用户听感是实打实的;
在错误率个位数的“贴身赛”里,10% 以上的相对降幅就是明显代差。
这正是Nomo-ASR 与通用模型的分水岭:模型训练与优化始终围绕真实设备音频展开,而不是只在“干净录音棚语料”上刷分。与之互相印证的还有两套高难度公开集——设备用户不会说播音腔普通话,方言口音集KeSpeech 上 Nomo-ASR 以 4.59% 拿下最优(领先0.86 pp);含远场噪声与网络口语的 WenetSpeech 上 5.54%,好于厂商 A/B/C。收音条件越“糙”,自研的相对优势越明显。
几个值得关注的点:
1. 设备真实收音+ 方言口音双最优:设备收音测试集6.11%(错误率最高降 51%)、KeSpeech 4.59%,均为五路第一——嵌入式设备语音正是我们专门优化的核心场景;
2. 英文3/3 全胜。LibriSpeech 上 1.60%,领先云厂商最优 0.81 个百分点;口音最杂的 Common Voice en 上,对云厂商最优值的领先最高达7.5 个百分点;
3. 诚实地说:在两套中文口语/众包集(WenetSpeech、CV-zh)上,最强云端大模型与我们互有胜负。综合 8 套,Nomo-ASR 以 6/8 最优、业务域与英文双领先拿下综合第一。
04
杀手锏:热词能力,设备听懂你的关键
通用ASR 遇到“TuyaOS”、“扫地机器人”这类词,最常见的输出是“to your os”、“少地机器人”。热词能力是我们的重点投入方向,横评结果也印证了这一点。
企业品牌热词实测(463 条真人录音,词表含 TuyaOS、TuyaOpen、Claude AI 等品牌与潮玩词汇):
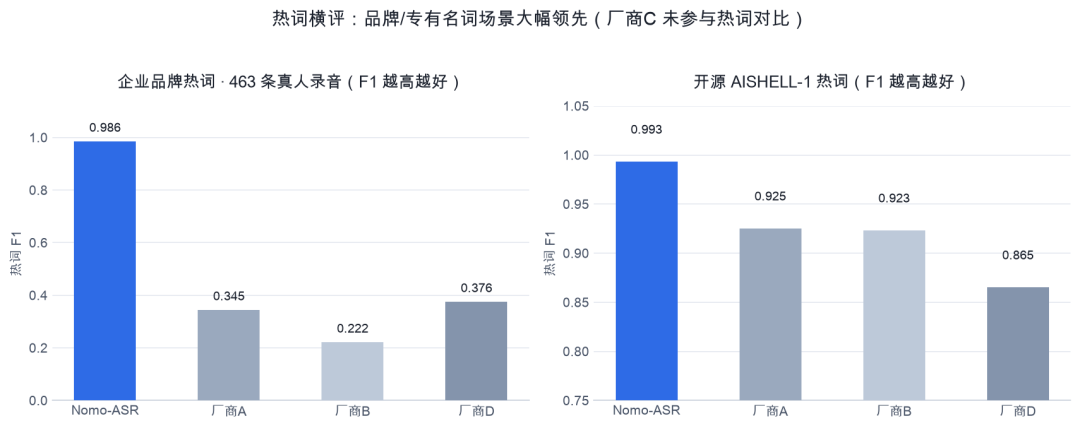
▲ 热词横评:企业品牌热词(左)与开源 AISHELL-1 热词(右),Nomo-ASR 均为最优
接近3 倍优于最强云厂商的 F1——在“设备必须叫对名字”的人机交互场景,这是质的不同。
在开源AISHELL-1 热词评测上,Nomo-ASR 同样以F1 0.993领先全部参测云厂商(0.865 ~ 0.925),且热词漏识字符占比(B-WER)仅 1.07%,抗干扰、少幻觉。
更重要的是工程可用性:热词会话内可动态更新。用户聊到新品类、新设备名,控制帧下发词表,下一句就生效,全程不断流。
05
流式体验:逐字刷新,稳如磐石
流式时延横评(统一40ms 分片、1× 实时节奏、单并发持续 5 分钟):
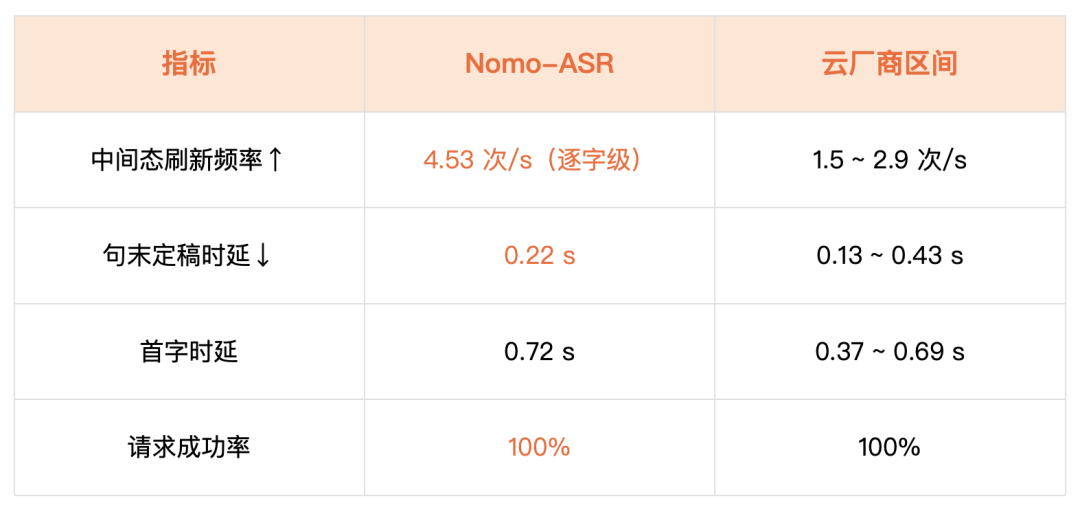
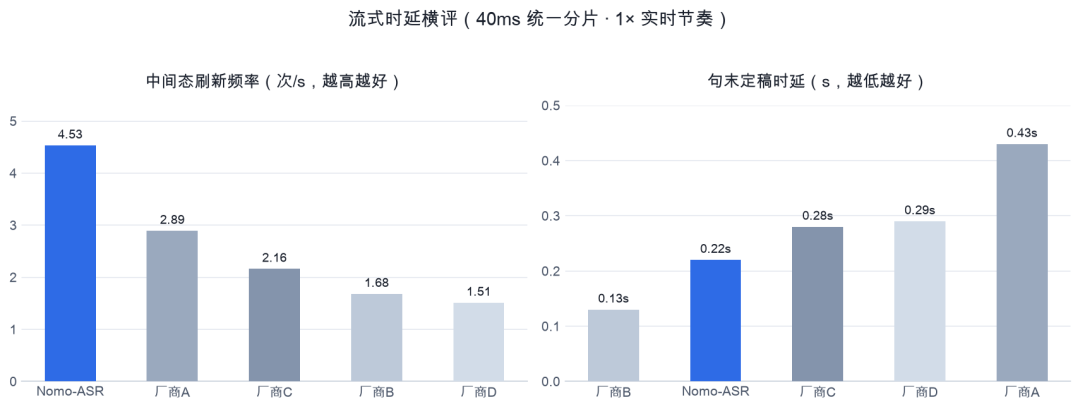
▲ 流式时延横评:中间态刷新频率(左)与句末定稿时延(右)
刷新频率全场第一:每秒4.5 次逐字级更新,是云厂商的 1.6 ~ 3 倍,字幕类场景“跟手感”可感知地更好;
极稳:单条音频下方差近乎为零(首字p95−p50 ≈ 1ms,刷新帧数恒定),不像云端常见抖动;
首字时延为五路最慢,我们如实标注,持续优化中;口径说明见文末。
06
业务验收:
真实设备与业务语料上的验证
算法
基准之外,模型还通过了业务侧的端到端验收测试,语料全部来自真实智能家庭交互场景:
跨设备收音验证(240 条自录音:两位说话人 ×
手机
/ T5 嵌入式盒子,四格均衡各 25%):在嵌入式设备真实收音上,混干扰词场景热词 F1 0.942、整句 CER 3.04%,与最优云端水平基本持平——收音质量变“糙”,热词能力不掉线;
智能家庭指令热词(中英文各44 条真实指令,覆盖房间/设备/模式/生僻词/品牌词):gRPC 链路真热词召回98.86%、B-WER 仅 1.11%(中文100%、英文 97.73%);全词表多热词注入下召回仍达 95.45%;
情绪、语种
标签
随定稿一帧返回,为上层对话与Agent 应用省去二次推理。
在线Demo:支持麦克风实时识别与音频文件上传,可体验实时波形、逐字刷新、定稿标点、热词命中高亮、点句回放。
如果你在做
智能音箱
、语音面板、机器人、会议/字幕类应用,欢迎接入试用,也期待你的反馈。
评测口径说明:
横评对象为四家主流云厂商在售商用 ASR API 与 Nomo-ASR,统一测试集、统一打分器;中文以 CER、英文以 WER 计,数值越低越好;“设备收音测试集”即涂鸦线上真实业务语音(Online 业务集,1,016 条线上真实业务音频);
热词 F1 衡量“真热词是否准确进入识别结果”,B-WER 为真热词漏识字符占比;“含干扰词”指注入词表混入干扰词的抗幻觉场景;
时延测试统一 40ms/1280 B 分片、1× 实时节奏:Nomo-ASR 为内网自部署服务,云厂商走公网 API,时延对比含网络链路差异;
评测周期为 2026 年 8 月,云厂商取当时各自正式推荐配置。
人机交互
人机交互
+关注
关注
12
文章
1335
浏览量
59329
ASR
ASR
+关注
关注
2
文章
48
浏览量
19609
涂鸦智能
涂鸦智能
+关注
关注
7
文章
361
浏览量
21528


