
 五度妙笔
 企业透视镜
 API商城

 数据库
奇异摩尔ODCC 2026开放数据中心大会主题演讲回顾
近期,2026开放数据
中心
大会暨首届算博会(2026 ODX )在北京成功举办。大会汇聚全球领军企业及业内技术专家,共同探讨计算、网络、存储、设施、液冷、算电等热点算力领域的最新动态与发展方向。奇异摩尔受邀参会,公司首席架构师朱琛于9月4日亮相2026 ODX “网络分
论坛
”,发表主题演讲《通用 IOD 在 Scale-Up 网络中的应用和标准化实践》,演讲聚焦 Agent 长上下文所带来的 KV Cache 存储挑战,系统梳理现有 KV Cache 卸载技术路线,阐明基于
以太网
构建的通用 IOD 在 KV Cache 卸载中的独特价值。
AI技术
的快速演进对内存系统构成严峻挑战。为此,业内各机构正积极寻求突破,以期完善
AI
基础设施,并进一步推动产业持续发展。在本次 O
DC
C 大会上,由中国信通院、腾讯、奇异摩尔等产业链公司发起“Memory Switch Fabric”项目圆满启动,其旨在 “如何把更大规模的内存连接成一片可共享、可调度、可扩展的地址空间”。在此前召开的 ODCC 春季全会网络工作组会议上,为应对下一代 AI 网络技术的演进需求,腾讯牵头正式成立 IO-NET 项目工作组,奇异摩尔是重要成员。作为该工作组的子项目,奇异摩尔牵头组织基于 IO-NET 的 IOD 芯粒工作组,联合产业链伙伴共同探索通用 IOD 的实现路径,为构建下一代 AI 互联生态提供更多技术路径选择。
以下为演讲回顾
随着大模型推理的上下文长度与并发规模持续增长,KV Cache 的显存占用已成为系统扩展的核心瓶颈。模型权重相对固定,而 KV Cache 随序列长度和并发 batch 线性增长,长上下文、大 batch 下甚至超过权重。显存不足会直接限制并发数、上下文窗口和整体吞吐,因此将 KV Cache 卸载到
CPU
DRAM
、远端内存池或持久化存储,是当前推理系统探索的演进路线之一。
(图源:奇异摩尔)
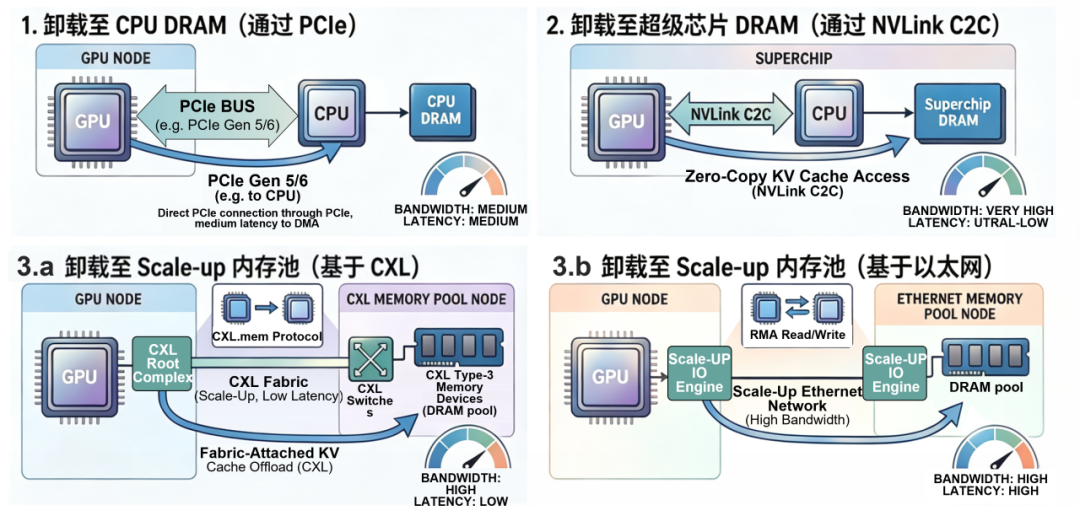
从卸载路径看,目前主要有三大类。
第一类,经 PCIe 卸载至 CPU DRAM,最通用、成本最低,但带宽和延迟均为中等,大规模卸载时容易成为瓶颈。
第二类,
英伟达
通过 NVLink-C2C 高速互连实现
GPU
与 CPU 间的异构缓存一致性,例如使 Gr
ac
e CPU 与 Hopper/Blackwell GPU 共享统一地址空间,可直接互访内存并保持缓存一致,减少数据拷贝与同步开销,但其生态并未完全开放。
第三类,使用 Scale-Up 域内存池进行卸载,又可细分为两种路径:路径①基于 CXL 的 Scale-Up 形成的内存池,带宽高,可突破单机 DRAM 容量限制,是未来内存池化的一种重要路径,但生态仍在成熟中,目前尚非最优解;路径②基于以太网的 Scale-Up 内存池(IO-NET),聚合带宽高、可跨节点长距离互联,且以太网生态成熟开放,基于此的内存池可与 XPU Scale-Up 共享同一张物理网络、同一套运维体系和同一套拓扑规划。
IO-NET内存池与大模型推理集群解构
在实际卸载与 KV Cache 的数据搬运过程中,必然需要一条合适的
通信
路径来支撑。当 Decoding 节点 的 HBM 无法容纳全部 KV Cache 时,多余的 KV Cache 需要被卸载并写入内存池;而在后续进行稀疏注意力计算时,本次选中的、且不在 HBM 中的稀疏 KV,又需要从内存池中重新取回。因此,Decoding XPU 与内存池之间必须建立一条高效的通信路径。
(图源:奇异摩尔)
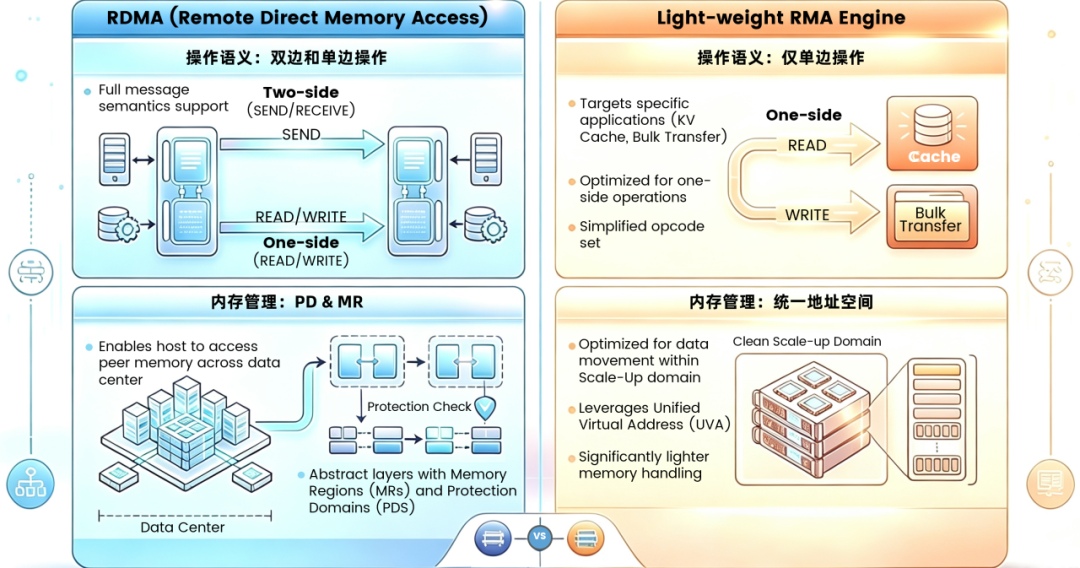
目前主要有传统 R
DMA
与轻量级 RMA 两条技术路线。
RDMA 是面向数据中心的成熟方案,支持双边 SEND/RECV 和单边 RE
AD
/WRI
TE
:双边操作需要收发双方 CPU 协同,适合消息传递;单边操作允许直接读写远端内存,无需远端 CPU 介入,适合大数据块传输。在内存管理上, RDMA 通过内存区域(MR)和保护域(PD)等抽象层,配合保护检查机制,实现跨数据中心的主机对等内存访问。这套机制安全隔离性强,但抽象层复杂,需要内存注册、地址固定和密钥交换,管理开销和延迟相对较高。
轻量级 RMA 则面向 Scale-Up 域和 KV Cache 卸载等特定场景,仅保留单边 READ/WRITE ,摒弃双边消息和复杂同步协议。内存管理上,它采用精简操作码集,使用统一地址空间和统一虚拟地址,节点可直接按全局虚拟地址发起远程读写,无需提前注册或分配保护域。由于 Scale-Up 域内节点物理距离近、互连可靠性高,轻量 RMA 因此可将延迟降至亚微秒级,并显著降低软件协议栈开销。
从实际应用场景来看,轻量级 RMA 引擎更适合承载这部分通信工作,而传统 RDMA 相对来说开销较大、较重。
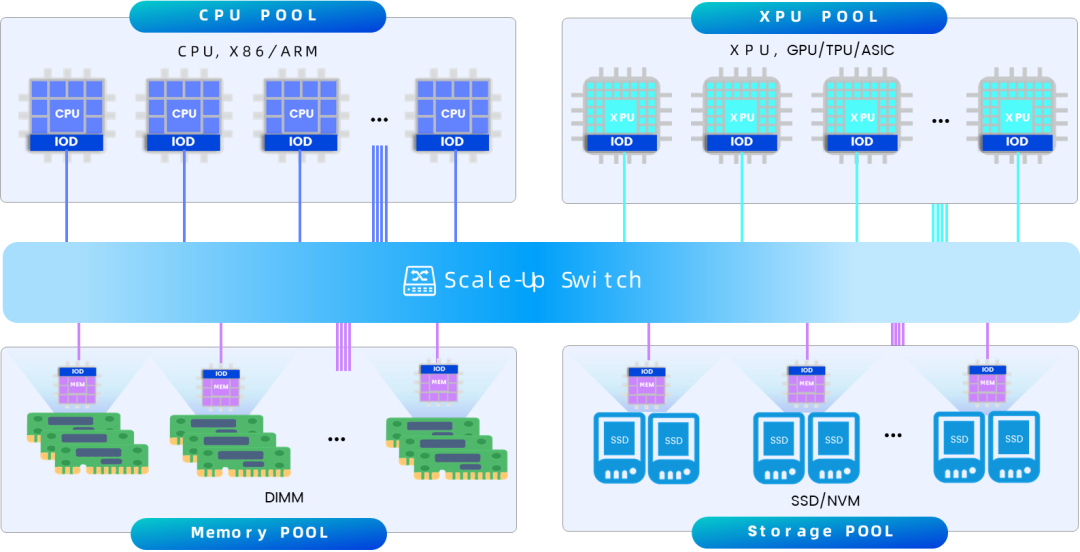
在上述底层机制的支撑下,计算架构本身也在发生深刻变革。传统“计算+内存+存储”一体化节点被拆分为 CPU、XPU、内存和存储四个独立资源池,通过统一的Scale-Up Switch 互连。采用 IO-NET 后, KV Cache 不再依赖节点间点对点传输,而是经内存池统一中转,实现控制与数据分离。计算节点无需板载大量 DIMM 插槽,有利于高密度部署;各资源池可独立扩展,提高利用率并支持异构计算。总体来看,解构式 Scale-Up 集群正推动 LLM 推理从紧
耦合
、显存受限向解构化、内存池化转型,通用 IOD 和标准化芯粒互连协议(如 UCIe )将成为关键基础设施。
(图源:奇异摩尔)
通用 IOD 在行业趋势下的应用
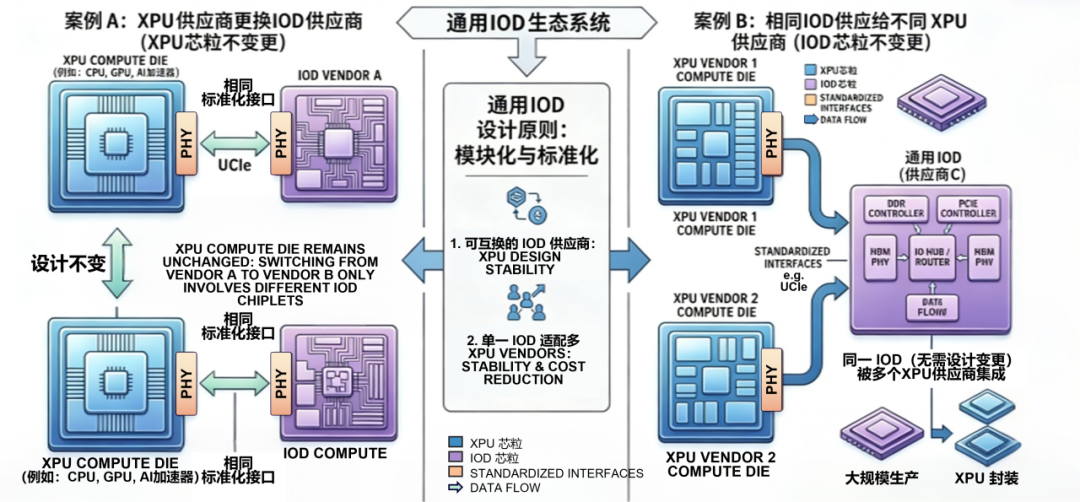
进一步看,正是这种解构式架构,推动通用 IOD 的设计理念从“与计算芯粒绑定”走向“与计算芯粒解耦”。其核心原则是:IOD 供应商可互换,同一 XPU 计算芯粒可搭配不同厂商的 IOD ;同一 IOD 也可适配多家 XPU 供应商的计算芯粒。实现这一点,依赖标准化芯粒间互连协议,如 UCIe 。
只要计算芯粒和通用 IOD 对外
接口
遵循统一标准,将在以下两种情况下为厂商提供极大便利。其一,XPU 供应商可选用多家 IOD 供应商:更换 IOD 时只需在封装层面替换芯粒,计算芯粒本身无需修改逻辑或布局,从而快速切换来源,避免被单一供应商锁定。其二,同一款通用 IOD 服务多家 XPU 供应商:不同厂商的计算芯粒只要遵循统一接口,无论内部是 GPU、TPU 还是定制
ASIC
,都可与同一 IOD 对接。IOD 供应商通过量产摊薄研发和制造成本,提高良率和供货稳定性;XPU 供应商则可聚焦计算核心差异化,缩短上市时间。
(图源:奇异摩尔)
通用 IOD 的落地,依赖 UCIe 协议栈与适配层的合理设计。通常而言,采用 UCIe 实现互联互通的场景,大多通过 AMBA 总线完成,但问题在于,UCIe 并未将这种映射方式标准化。正是标准的缺位,才引出了后续一系列通信路径与互操作问题。例如,若双方内部均使用 AMBA AXI,却各自定义 AXI 到 UCIe FLIT 的映射规则,那么即便物理层与适配层都符合 UCIe ,只要协议层的数据语义、打包方式、顺序保证和流控
信号
不一致,通信仍无法正常进行。也正因如此,从行业健康发展与未来趋势来看,推动标准化的映射格式,是打破私有协议锁定、实现互联互通的关键一步。
UCIe 互联互通:
从标准文本到开放生态的必经之路
上文提到,UCIe 市场虽已形成初步技术共识,但生态层面仍呈现显著碎片化。各厂商在物理层兼容性上有所趋同,却在协议层实现上互不相通,导致即便同样宣称遵循 UCIe 标准的 IP ,在实际集成时也常因各种差异而无法真正互通。这不仅大幅增加了芯粒集成的验证复杂度与设计成本,更迟滞了异构计算从单点定制走向规模化复用的进程。
作为行业领先的AI网络全栈式互联产品及解决方案提供商,奇异摩尔的产品包括Kiwi Link UCIe D2D IP,可支持 C2C 互联,并首创了专为超节点网络设计的Kiwi G2G IOD通用IO芯粒方案。
针对上述 UCIe 生态碎片化痛点,在近期结束的 ODCC 大会上,由腾讯主持、奇异摩尔主创,并联合多家 XPU 厂商和产业链上下游企业共同完成了《 IO-NET 芯粒报告》(以下简称“报告”)。奇异摩尔在《报告》中率先提出并定义了“ AXI over UCIe FLIT ”标准化协议层适配方案。(该报告将在ODX官网公开发布,敬请关注。)
该方案以 FLIT 为基本粒度,将广泛通用的 AXI 总线协议映射至 UCIe 物理传输层,构建起一套统一、可验证的协议转换桥梁。这不仅有效屏蔽了不同厂商在链路层和事务层上的实现差异,更以开放参考设计的形式,为 XPU、IOD 等芯片设计方提供了一条低门槛、高兼容的互联路径,为 Chiplet 与异构集成体系夯实了互联互通的基石。更具战略意义的是,该方案为池化内存架构迈向产业落地扫清了关键的接口障碍,也为产业链各环节的协同创新提供了统一的技术语言——厂商可以在同一标准下各展所长,而无需在互联适配上一再重复投入,从而加速整个智算集群生态的成熟。
数据中心
数据中心
+关注
关注
18
文章
6279
浏览量
76271
算力
算力
+关注
关注
2
文章
2392
浏览量
17330
奇异摩尔
奇异摩尔
+关注
关注
0
文章
104
浏览量
4186
原文标题:ODCC演讲回顾 | AI 存储前瞻,通用IOD在Scale-Up网络中的应用和标准化实践
文章出处:【微信号:奇异摩尔,微信公众号:奇异摩尔】欢迎添加关注!文章转载请注明出处。


