 五度妙笔
 企业透视镜
 API商城

 数据库
科大讯飞星火语音基座大模型Spark-Audio-1.0-Preview发布
今天,Spark-Audio-1.0-Preview上线啦——一款基于全国产化算力训练的语音基座大模型。
大家对大模型并不陌生,语音基座大模型又是什么呢?
过去,我们处理
音频
大多采用级联方案:先把语音转成文字,再交给大模型理解。这种做法有两个明显短板:
信息丢失。文字只能记录说了什么,会丢掉语音里自带的语气、情绪,还有背景环境音等关键信息,导致模型对场景的判断不完整,自然也会影响到最后的结果。
链路割裂。这套系统把语音转写、声纹识别、语音翻译等能力拆成独立模块串联运行,模块之间存在断点,不仅容易累积错误,在使用体验上也会出现延迟、卡顿。
语音基座大模型就解决了上面的这些问题:它不再只做语音转文字,而是直接理解语音。语音基座大模型一次性听懂人声、环境音、音乐等等,而且还能理解声音里的语义、情绪和场景。
此次首发的Spark-Audio-1.0-Preview采用 0.65B(Dense结构)的音频编码器,搭配30B-A3B(MoE结构)的大语言模型,使用了1300万小时音频以及大量文本数据,基于纯国产算力集群训练完成,是地道的国产语音基座大模型;在同一个模型中可输入文本和语音两个模态,支持语音转写、多语言翻译、多方言识别、环境音识别、说话人识别、情感分析以及复杂的音频
问答
等任务,让机器从“听清”进一步走向“听懂”。
Spark-Audio-1.0-Preview在各项语音评测任务上效果整体相当、部分超过,尤其在复杂场景高噪声、小声说等偏真实应用类任务上明显领先;与尺寸更大的闭源语音基座模型相比,Spark-Audio-1.0-Preview的表现也十分接近。与讯飞星火大模型的1+N体系类似,在语音基座大模型上也可进行微调,开发语音识别、语音同传、语音交互等专用模型或者系统,在相关语音业务中落地。
多语言、多方言、复杂场景表现优秀
Spark-Audio-1.0-Preview可支持99种语言及202种方言的识别。在多项任务中,与同尺寸的Qwen3.5-omni-flash(35B-A3B)相比在平均效果上表现出了多语言、多方言
语音识别
上的优势;与尺寸高一个数量级的Qwen3.5-omni-plus效果接近。
在Fleu
rs
、Kespeech、LibriSpeech等中英文、多语言、多方言语音识别评测任务中,Spark-Audio-1.0-Preview得分高于Gemini-3.1 Pro;Fleurs-中文测试集中,Spark-Audio-1.0-Preview取得了SOTA。
面向更实际的应用场景,Spark-Audio-1.0-Preview在复杂场景的高噪声、小音量等复杂条件下的语音识别评测任务中也有较为明显的领先优势。
在文本相关的评测任务上“不降智”是语音基座大模型的难点之一。
此次发布的Spark-Audio-1.0-Preview在通用知识、数学与代码等任务上没有出现明显降智,同时在指令遵循、对话、音频理解等任务上仍有进步追赶空间。下一步,我们将在巩固、加强优势的同时补齐短板,交出更好的成绩。
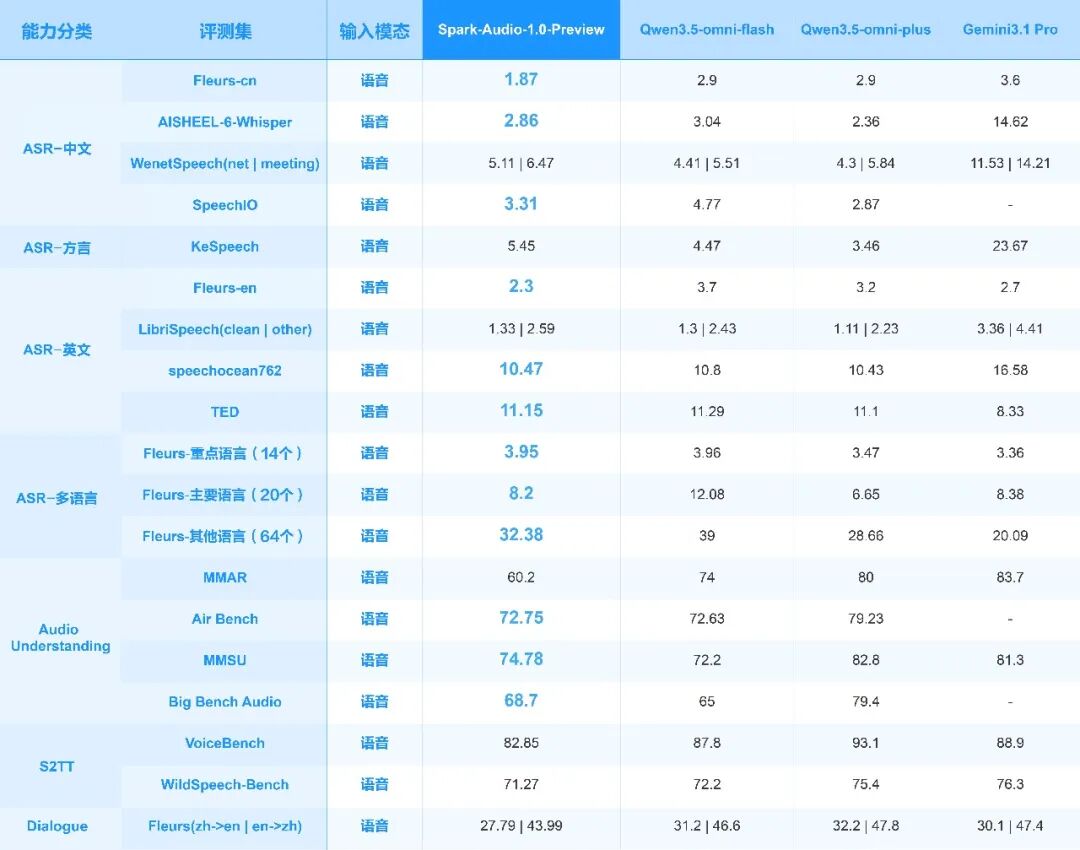
公开测试集-音频
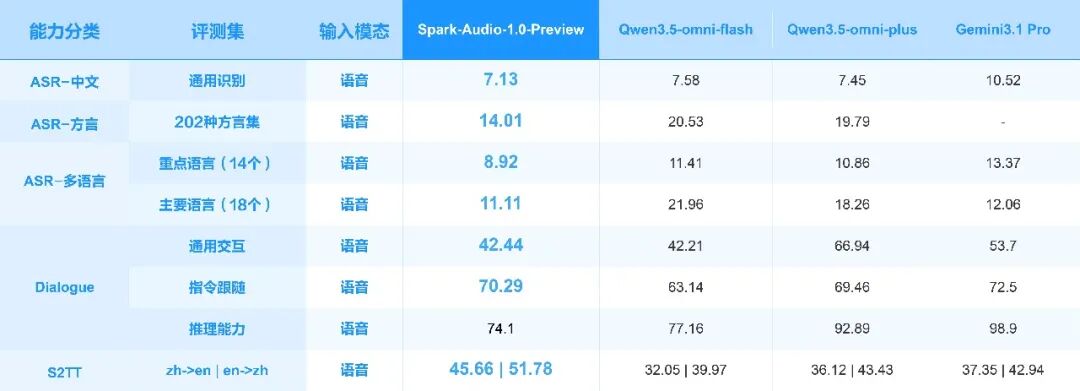
自建测试集-音频
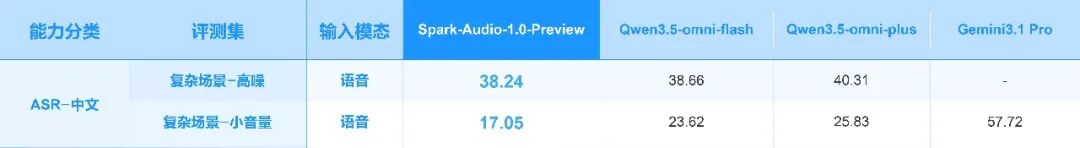
自建测试集-音频-复杂场景
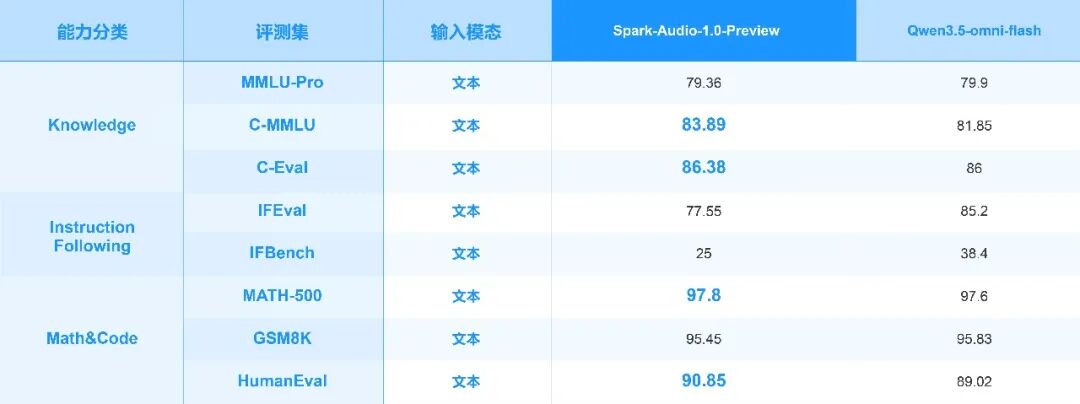
公开测试集-文本
*注:测试集中ASR(语音识别)相关任务使用WER/CER作为评价指标,数值越低表示效果越好;
S2TT语音翻译任务使用BLEU分作为评价指标;
其他任务均使用准确率作为指标,数值越高表示效果越好。
测试集来源
自建评测集:来自于语音真实任务请求数据,来源分布包括讯飞星火APP、讯飞听见APP、讯飞翻译机、讯飞输入法、讯飞开放平台语音A
PI
真实
开发者
场景等进行滚动更新;
重点语种:Chinese, English, Japanese, Spanish, Arabic, German, French, Italian, Portuguese, Korean, Russian, Hindi, Thai, Vietnamese,共14个语种。
主要语种:Bulgarian, Bengali, Czech, Greek, Persian, Filipino, Indonesian, Kazakh, Mongolian, Malay, Dutch, Polish,
Rom
anian, Swedish, Swahili, Tamil, Turkish, Ukrainian, Urdu, Uzbek,Uyghur ,
Ti
betan,Hausa,共23个语种。评测Fleurs集时,该部分只统计了20个语种,Uyghur、Tibetan、Hausa因个别家效果异常,未参与统计。评测自建多语言集时,该部分只统计了18个语种,Uyghur、Tibetan、Hausa、Tamil、Dutch因个别家效果异常,未参与统计。
其他语种:
Can
tonese,Afrikaans, Amharic, Assamese, Asturian, Azerb
ai
jani, Belarusian, Bosnian, Catalan, Cebuano, Welsh, Danish, Estonian, Fula, Finnish, Irish, Galician, Gujarati, Hebrew, Croatian, Hungarian,
Arm
enian, Igbo, Icelandic,
Java
nese, Kamba, Kabuverdianu, Khmer, Kannada, Kyrgyz, Luxembourgish, Luganda, Lingala, Lao, Lithuanian, Luo, Latvian, Maori, Macedonian, Malayalam, Marathi, Mal
te
se, Burmese, Norwegian, Nepali, Northern Sotho, Nyanja, Occitan, Oromo, Punjabi, Pashto, Sindhi, Slovak, Slovenian, Shona, Somali, Serbian, Telugu, Tajiki, Umbundu, Wolof, Xhosa, Yoruba, Zulu,Sorani‑Kurdish,共65个语种(含汉语方言-粤语)。评测Fleurs集时,该部分只统计了64个语种,Sorani‑Kurdish因个别家效果异常,未参与统计。
Spark-Audio-1.0-Preview是怎样训练出来的?
Spark-Audio-1.0-Preview通过音频编码器预训练,逐步扩展音频编码器的表征能力;再通过预训练和后训练,提升了模型的基础能力、复杂场景泛化性以及多个任务效果,最终使得Spark-Audio-1.0-Preview在99种语言、202 种方言及高噪声、小音量等复杂场景下取得优异成绩。
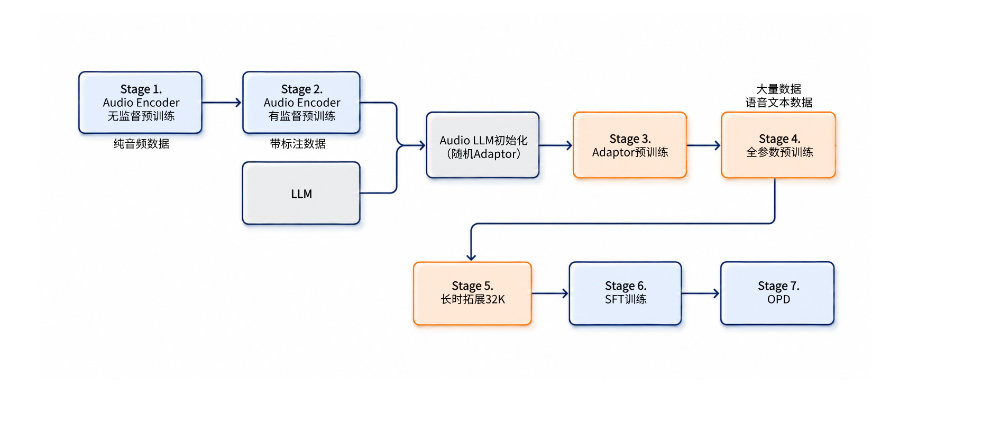
Spark-Audio-1.0-Preview训练流程图
同时,Spark-Audio-1.0-Preview是业界首个基于全国产算力训练的语音基座大模型,也证明了在国产算力上完全有能力训推出效果达到业界领先水平的语音基座大模型,再次证明了我们在全国产算力平台上训推大模型的实力。
让智能语音深入更多真实场景
语音基座大模型的价值,不只在于把一句话转成文字,更在于理解这句话是怎么说的、由谁说的、在什么环境中说的,以及前后发生了什么。
在客服、汽车座舱和
机器人
等场景中,它可以识别用户的情绪和表达方式,让对话更连贯、更有温度;在实时翻译和跨语言会议中,它能够保留语气、语调等韵律信息,带来更自然的交流体验;在
医疗电子
病历、会议转写和内容审核中,它可以自动区分说话人、提取关键决策点,并生成结构化纪要,帮助工作人员减少重复整理。
随着语音基座大模型能力不断提升,智能语音还将进入更多工作和生活场景:从嘈杂环境中的指令识别,到多方对话中的重点提炼;从方言交流到跨语言沟通,机器与人的语音交流路径将拥有更多可能。
目前,Spark-Audio-1.0-Preview已正式开放体验,API后续将上线讯飞开放平台;基于Spark-Audio-1.0-Preview语音基座大模型,我们还将在近期陆续展开一系列语音相关大模型的发布和升级,期待大家的关注、体验和反馈。
*文中数据来源于实际应用
科大讯飞
科大讯飞
+关注
关注
19
文章
902
浏览量
65559
大模型
大模型
+关注
关注
2
文章
4338
浏览量
5852
原文标题:讯飞星火全国产语音基座大模型Spark-Audio-1.0-Preview上线了!
文章出处:【微信号:iFLYTEK1999,微信公众号:科大讯飞】欢迎添加关注!文章转载请注明出处。


