
 五度妙笔
 企业透视镜
 API商城

 数据库
EAI182X-M2 新品发布:不换主控,插卡升级,怎么让存量设备获得 20TOPS 本地大模
在端侧
AI
的性能讨论中,TOPS长期是最常被比较的指标。但当大语言模型进入终端,一个更基础的约束开始主导实际体验:
数据能否以足够快的速度送达计算单元。
以RK3588为例,其内置NPU提供6TOPS算力,在YOLO检测、人脸识别等CNN类任务中表现稳定。但运行大语言模型时,实测输出速度仅约14 tokens/s(Qwen2-1.8B,W8A8量化,第三方数据)。
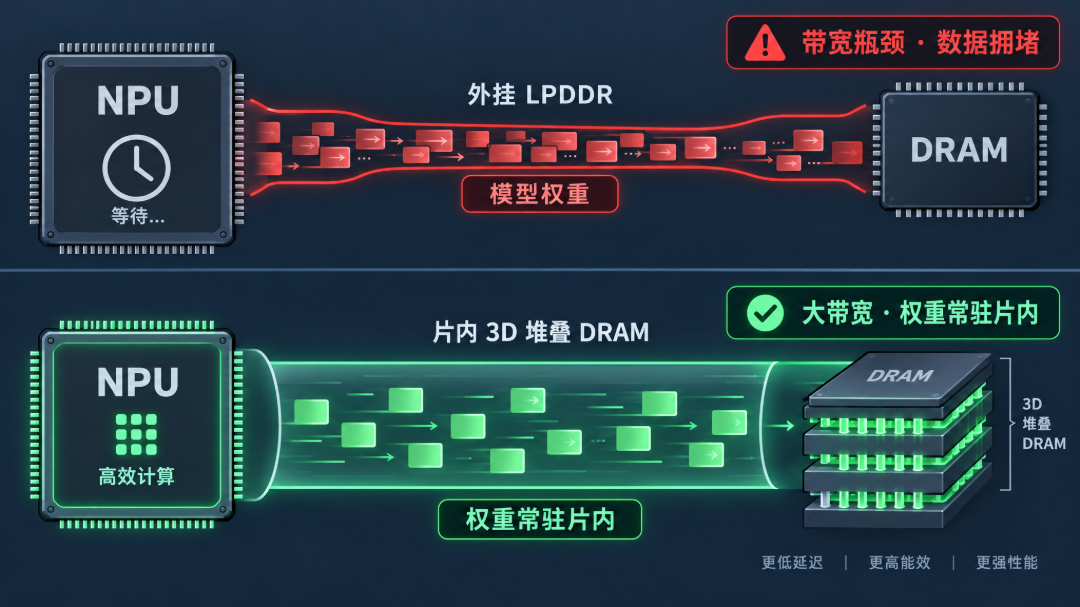
瓶颈并非算力不足——而是模型权重在内存与NPU之间的搬运速度跟不上计算消耗。这个被称为
「内存墙」
的约束,正在成为端侧大模型落地的第一道门槛。
01
内存墙与3D堆叠
TOPS换不来生成速度,带宽可以
大语言模型的推理与CNN类任务有本质区别。CNN是一次性前向计算,权重读取一次即可;而LLM采用
逐Token自回归生成
——每生成一个token,都要把整层模型权重从内存读取一遍,长上下文还会让KV Cache访问量持续攀升。
这意味着LLM是典型的
带宽受限型(bandwidth-bound)负载——其实际性能主要受内存带宽制约,而非NPU峰值算力决定
。传统SoC中,
操作系统
、显示、视频与AI计算共享外部内存,权重搬运需跨
PCB
、跨封装,且LP
DDR
外挂总线存在物理带宽上限。就会导致一个后果:算力再高,内存喂不上来,NPU就是空转。
RK182X的解法不在SoC内部挤带宽,而是
单独做一颗AI协
处理器
,把高带宽
DRAM
直接叠封在NPU上方——逻辑晶圆与定制LPDDR晶圆通过TSV(硅通孔)混合键合垂直层叠,互联路径从"跨PCB、跨封装"缩短为"垂直穿通"。
片内DRAM与算力(datasheet):
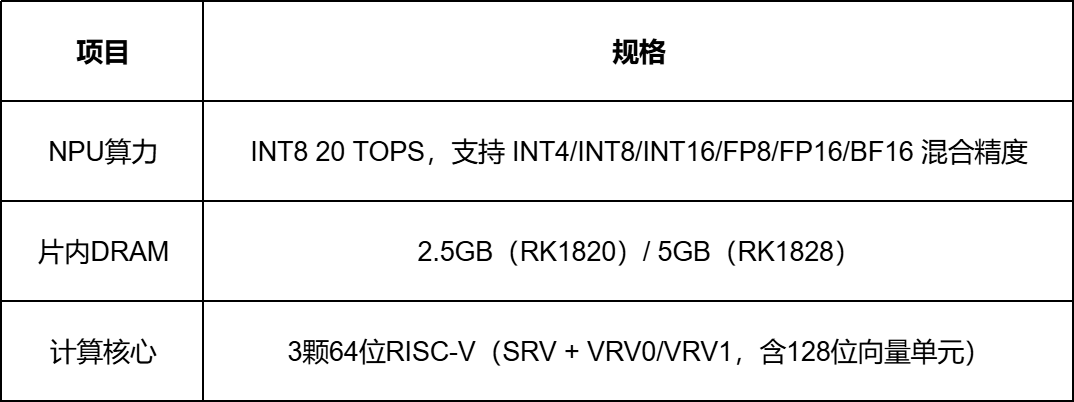
7B模型INT4量化后约
4G
B,RK1828的
5G
B片内内存可完整装下,权重全程常驻片内,无需与主控反复交换——这是突破内存墙的物理基础。
02
协处理器架构与 EAI182X-M2
不换主控,插卡升级
理解RK182X的关键在于——
它不是SoC,是一张AI算力卡
。
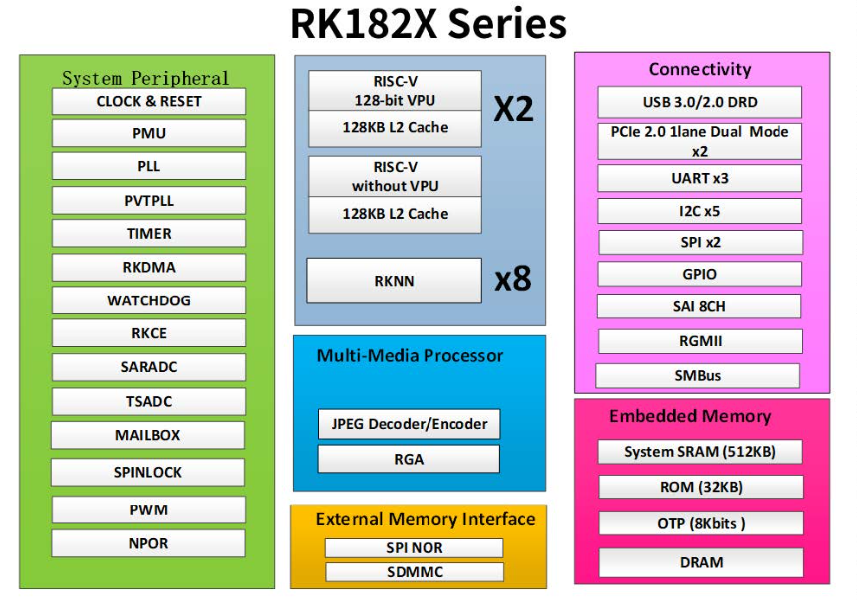
3588、3576这类SoC是完整片上系统,插电即可跑系统;而RK182X只有NPU加高带宽DRAM(3颗
RISC-V
核用于任务调度,不直接跑模型)。最接近的类比是PC里的独立显卡:
主控是3588/3576,推理任务通过PCIe下发给RK182X,结果再返回
。
互联
接口
: 2路 PCIe 2.1(单通道,RC模式,2.5/5.0Gbps)、1路
USB
3.0 DRD + 1路 USB 2.0 DRD、1路千兆
以太网
RGMII,并内置AES/SM4、SHA/SM3、
RS
A 4096、ECC 256、SM2等安全引擎。
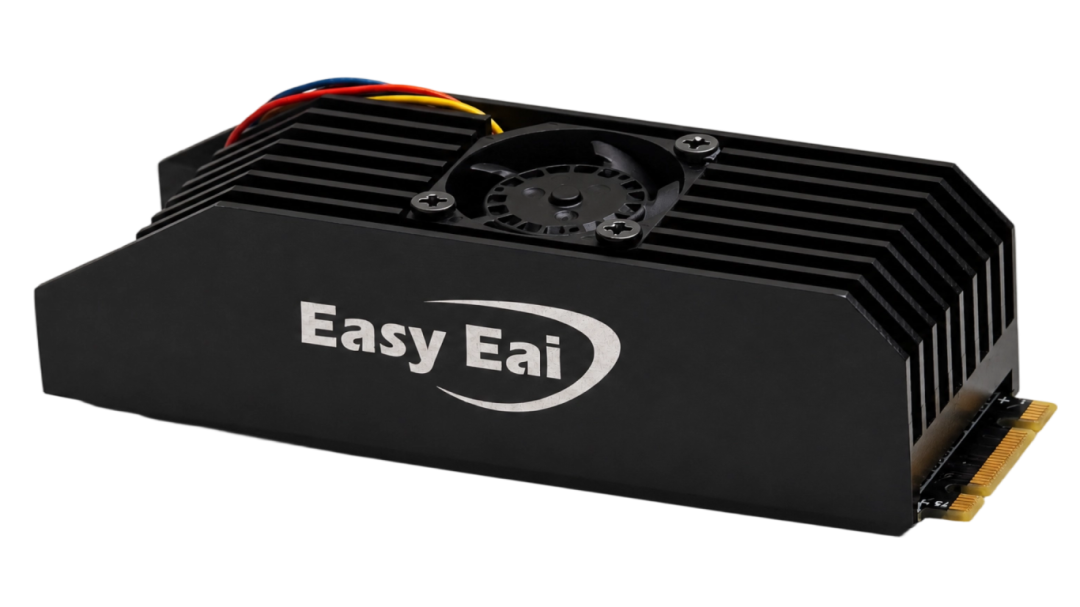
灵眸科技 EAI182X-M2
灵眸科技 EAI182X-M2
即基于该架构,采用标准
M.2形态(Key B-M)
,适配 RK3588 / RK3576 / RK3568 等
瑞芯微
主控平台作为Host:
互联: PCIe 2.1 与主控协同,主控继续承载操作系统、显示、视频与外设控制
算力: NPU INT8 20 TOPS,混合精度支持
存储: 片内3D堆叠DRAM,2.5GB(RK1820)或 5GB(RK1828)
工具链:配套RKNN3(区别于此前的RKNN/RKNN2,提供C A
PI
,支持模型转换、推理与性能评估)
模型: 支持LLM、VLM、CNN三类核心模型本地化部署,兼容Qwen、DeepSeek、GLM、MiniCPM、Llama等主流模型
产品形态:
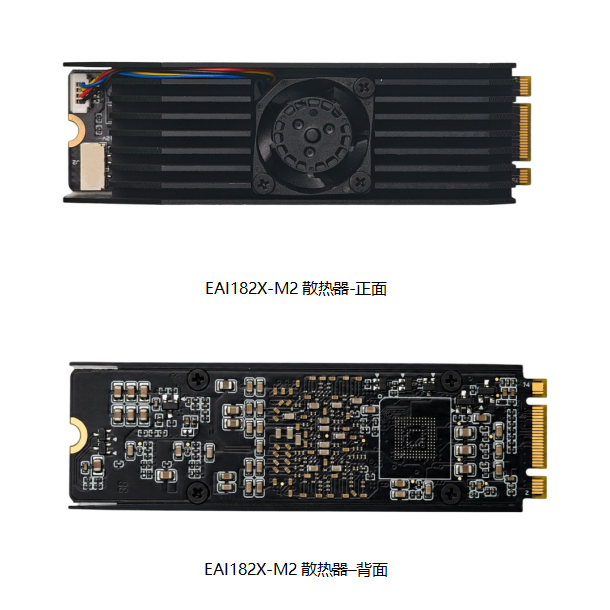
卡片正面覆盖黑色金属散热鳍片并嵌入主动散热风扇;背面为完整PCB,板载RK182X主控与片内DRAM堆叠封装,右侧为M.2金手指。
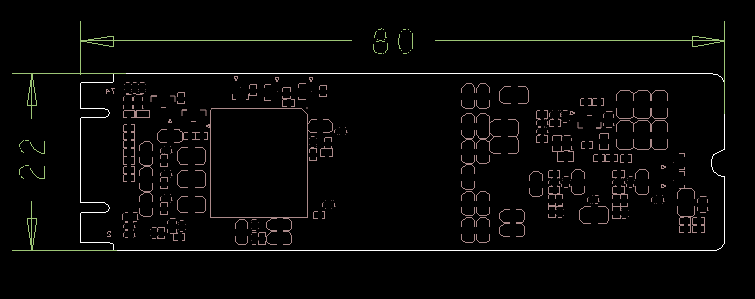
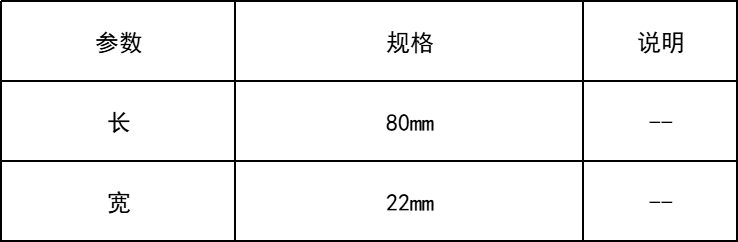
机械
尺寸:
这种
"SoC + AI协处理器"
双轨架构的工程价值在于:
一台已量产的RK3588/RK3576/RK3568板卡,只要预留M.2插槽,插上即可获得20TOPS独立NPU算力,
无需更换主控、重新画板、重新做产品
认证
。对工业、车载这类主控生命周期长达5~7年、而AI模型几个月一迭代的场景,等于为AI能力保留了一条独立升级通道。
03
模型支持范围、实测性能
与模型精度
当前已支持模型:
目前支持的模型包括但不限于以下:
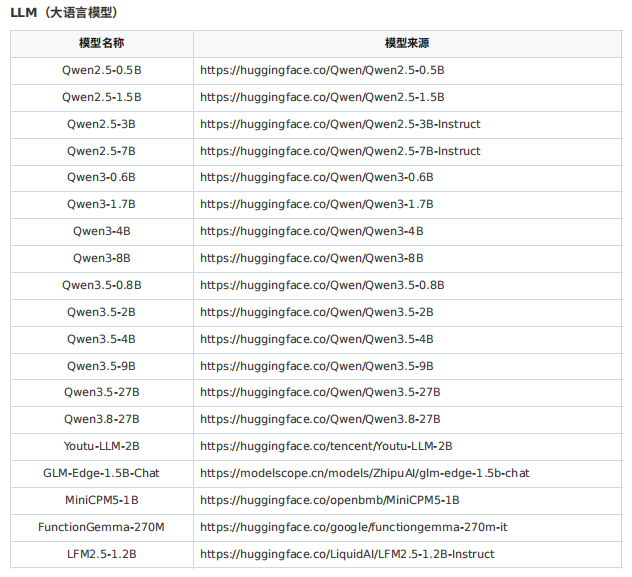
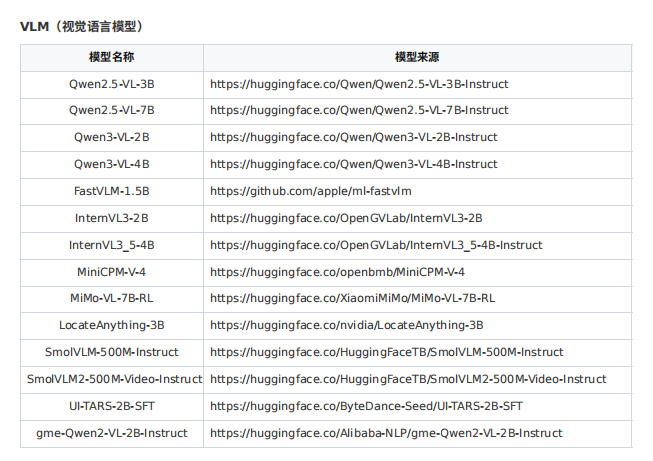
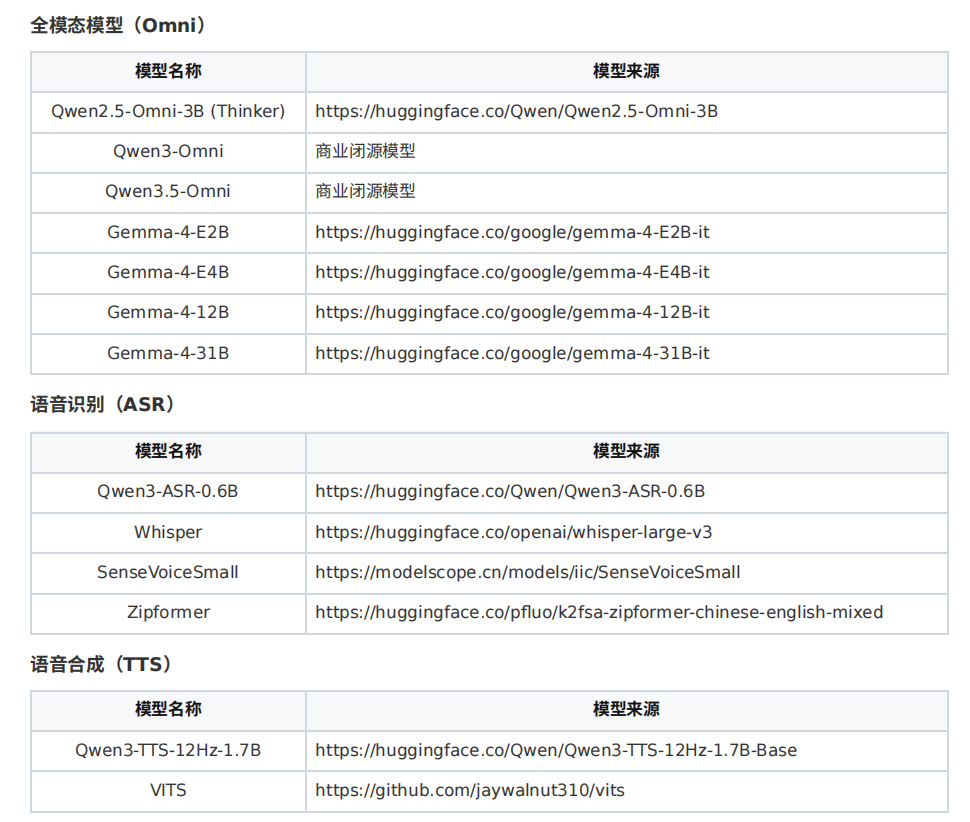
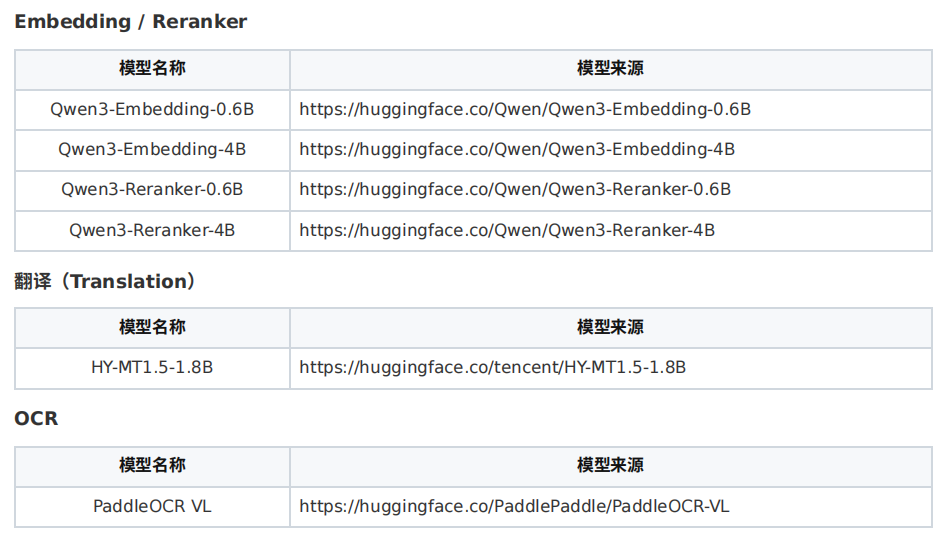
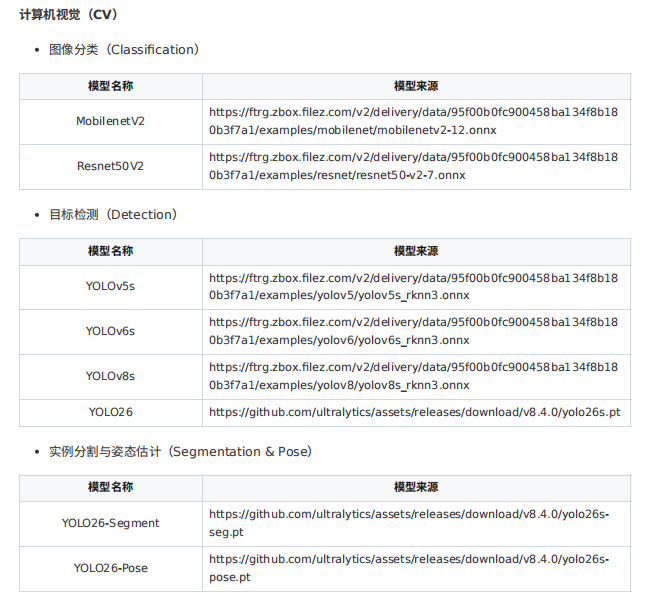
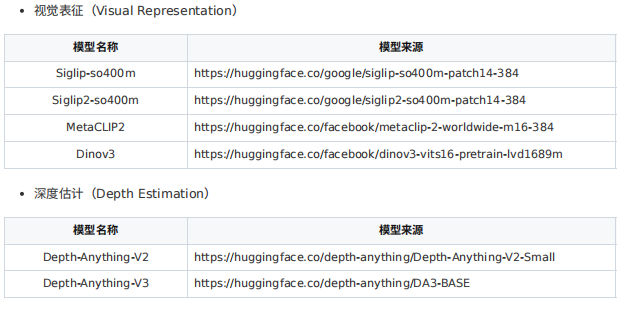
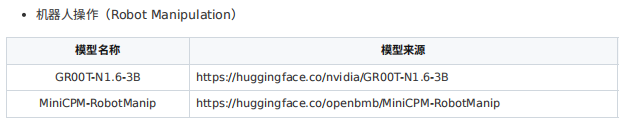
(上下滑动查看全部内容)
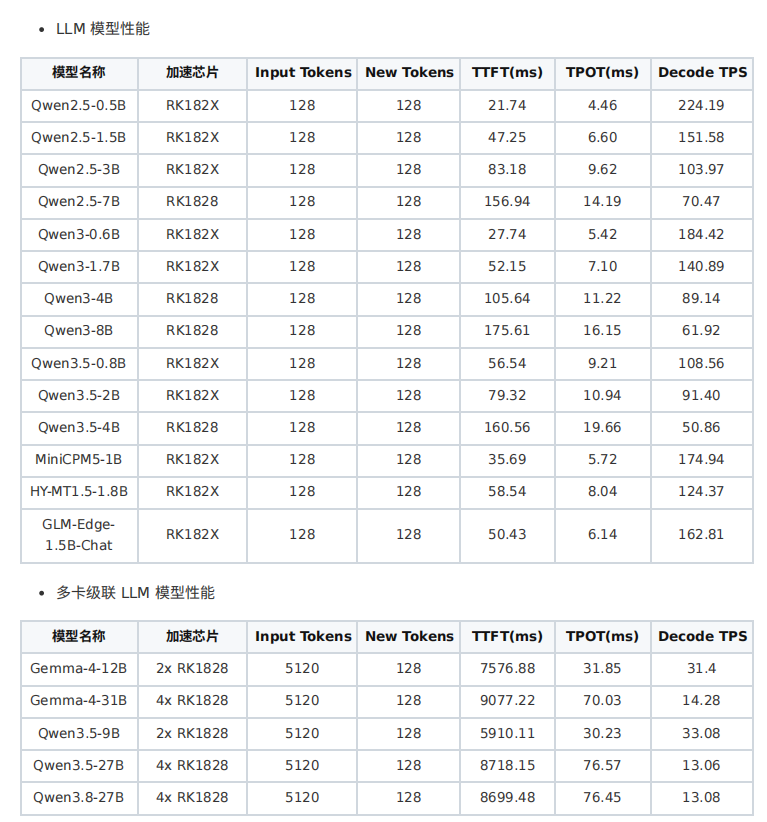
模型性能:
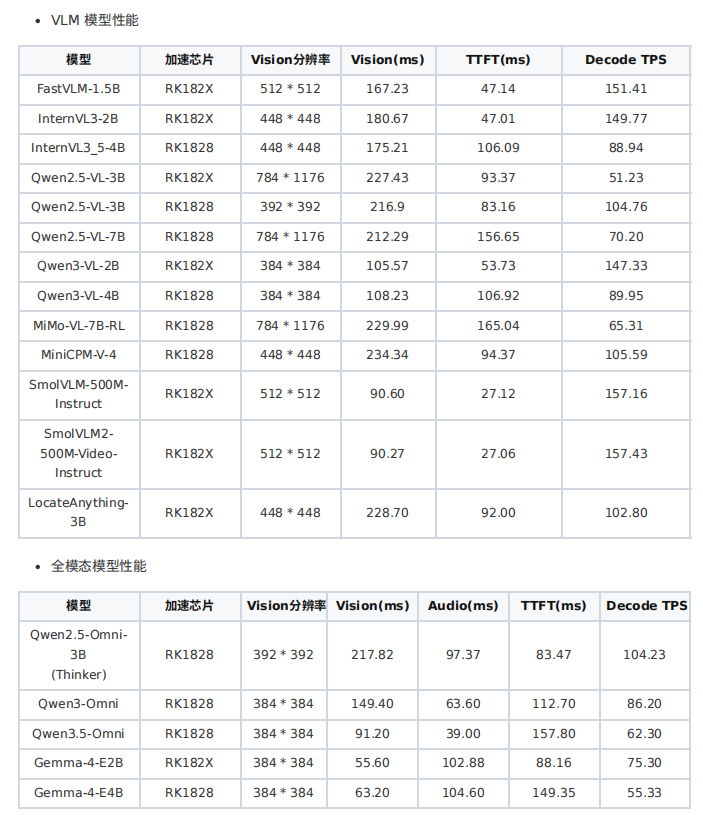
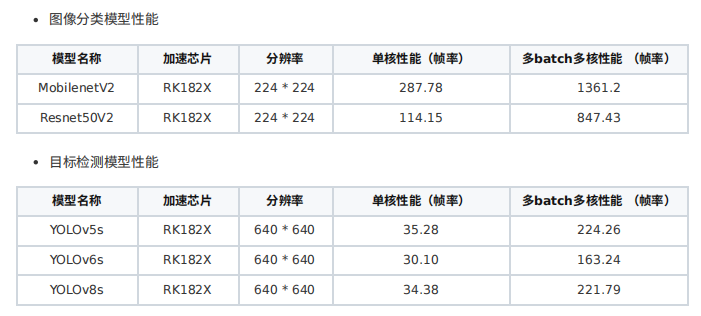
(上下滑动查看全部内容)
注:
1. RK182X 表⽰加速芯⽚可为 RK1820 或 RK1828。
2. Qwen2.5-VL-3B:
-如果使⽤ RK1820 加速芯⽚,采⽤两段式运⾏⽅案(LMHe
ad
在RK3588上执⾏);
-如果使⽤ RK1828 加速芯⽚,模型推理完全在协处理器端执⾏。
3. RK1820/RK1828协处理器NPU频率均为1GHz。
4. 测试基于RK3588 + RK1820/RK1828,两者之间通过PCIe连接,RK3588 设置为性能模式。
5. T
TF
T:模型⽣成第⼀个 token 所需的时间。
6. TPOT:⽣成每个输出 token 所需的平均时间。
7. TPS:模型每秒能⽣成的 token 数量。
8. VLM 的 Vision 和 LLM 耗时为独⽴测试,LLM部分的 Input Tokens 和 New Tokens 均设为128。
9. 多卡级联测试基于 RK3588 主控 + 多张 RK1828 协处理器(采⽤流⽔线并⾏级联),RK3588 设置为性能模式
模型精度:
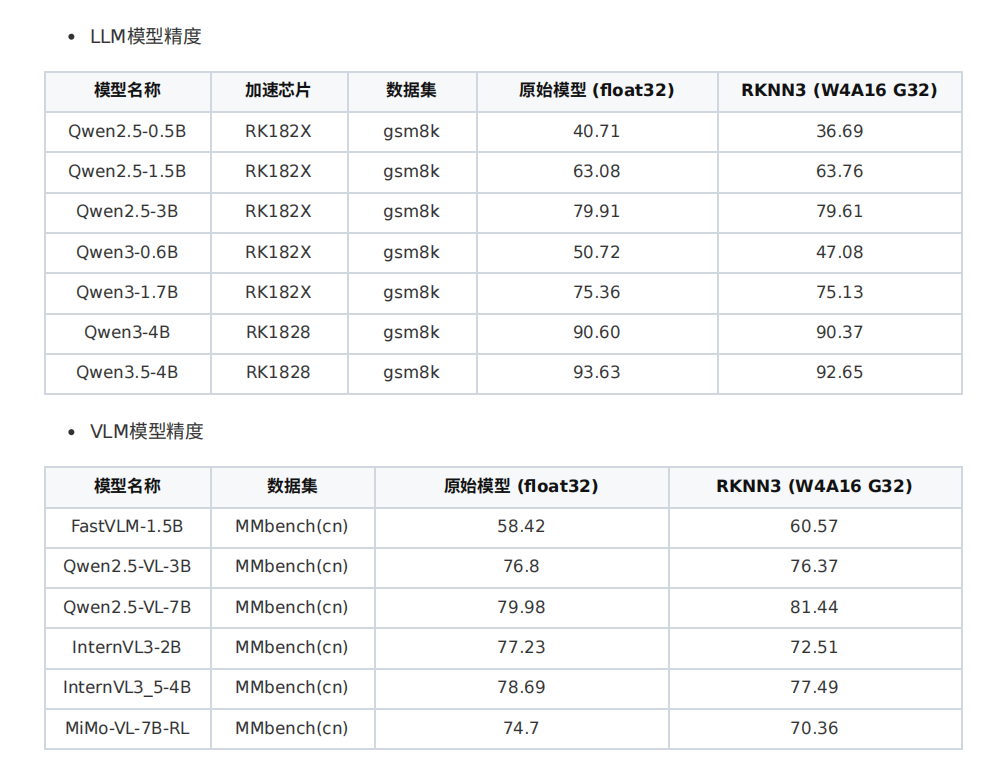
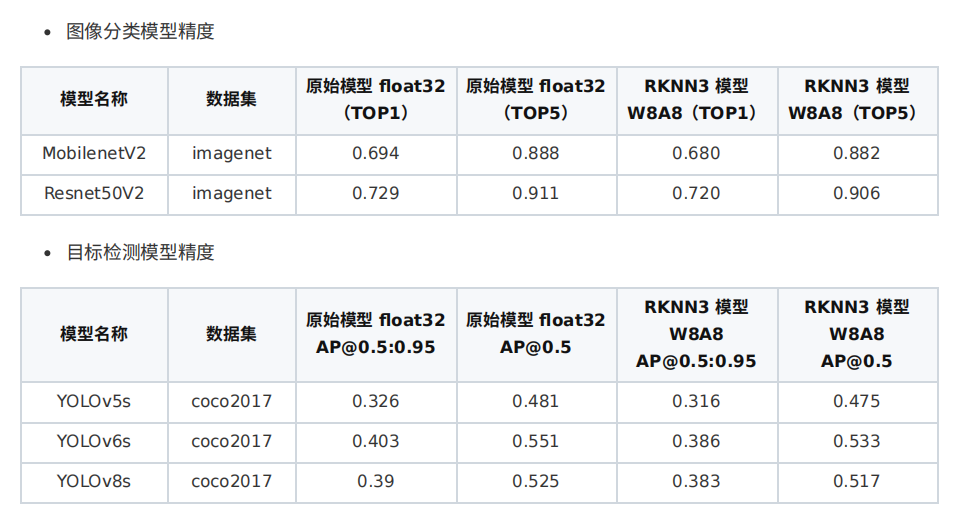
端侧AI进入BOM的前提,是能够被量化为实际的体验提升或成本回报。对已部署大量RK3588/RK3576/RK3568平台的客户而言,"不换主控、插卡升级"意味着AI能力的引入不再伴随一次完整的硬件改版与重新认证——这是EAI182X-M2最直接的价值。
同时我们也建议客户在选型时先明确负载类型:以大模型交互为主,协处理器路线收益明确;以传统视觉检测为主,主控自带NPU已能满足需求,无需重复投入。
EASY-EAI灵眸科技长期基于瑞芯微平台提供
嵌入式
软硬件方案,EAI182X-M2 的推出进一步完善了从主控核心板到AI算力扩展的产品矩阵。关于该算力卡的完整硬件规格、实测数据、配套底板参考设计与供货信息,欢迎前往
EASY EAI官网
获取
最新资料
,或与我们的技术团队对接项目需求。
AI
AI
+关注
关注
92
文章
45941
浏览量
306655
语言模型
语言模型
+关注
关注
0
文章
582
浏览量
11696
大模型
大模型
+关注
关注
2
文章
4346
浏览量
5856


