
 五度妙笔
 企业透视镜
 API商城

 数据库
海归博士带队,这家上海硅光公司融了数亿元
如果你关注AI,可能听过一个说法:训练大模型,卡不够用是问题,卡和卡之间“说话”太慢,也是问题。当成千上万张GPU要协同干活时,它们之间传输数据的效率,直接决定了整个集群能不能跑得快、跑得省电。
传统方案靠电信号在铜线里跑,带宽有限、功耗高,到了万卡级别就开始“堵车”。而用光来传数据,被普遍认为是破局的方向。
11月6日,投中网获悉,上海孛璞半导体技术有限公司完成数亿元B轮融资,投资方包括华映资本、凯联资本、东南网架、上海科创集团知识产权基金、舜意投资等。这家2022年成立、由海归博士邢宇飞与创始团队共同创办的公司,做的正是用硅光技术给AI算力“修路”的生意。
结合孛璞半导体官网信息,我们试着拆解一下这家公司到底在做什么、技术上有哪些看点。

| 修路用的“材料”:硅光
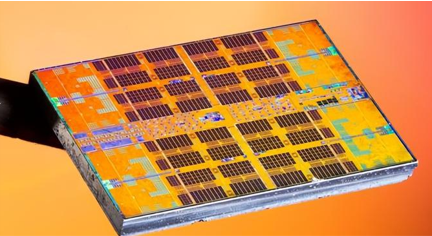
简单说,硅光就是把原本用分立光学元件实现的功能,集成到硅芯片上。传统光通信模块里,激光器、调制器、探测器各是各的零件,体积大、组装复杂。硅光技术则试图把这些“光路”像电路一样刻在硅片上,用半导体工艺批量制造。
好处很直接:带宽高、功耗低、体积小。官网对硅光技术的描述也印证了这一点——它是解决数据中心、高性能计算和AI集群中数据传输瓶颈的关键技术。孛璞的核心团队在硅光领域深耕超过15年,来自Intel、IMEC等机构,这为它的技术路线提供了底子。
| 孛璞三条产品线
从官网的产品中心看,孛璞的业务可以归为三个方向,逻辑上是一条线:让数据在芯片间、板卡间、集群间传得更快更省。
第一个是OCS光交换机。 OCS全称光电路交换,你可以把它理解为一个“光的路由器”。传统电交换机要把光信号转成电信号、处理完再转回光,来回折腾既慢又费电。OCS则让光信号直接通过,中间不落地。孛璞已经量产8×8的OCS芯片,正在向128×128规模演进,远期规划1024×1024。官网引用的参考数据显示,对比传统电交换架构,OCS方案可减少电交换机数量高达87%,降低功耗40%,延迟减少10%。对于动辄万卡规模的AI集群来说,这个账算得过来。

第二个是高速光收发引擎。 覆盖400G到1.6T速率,支持NPO(近封装光学)和CPO(共封装光学)等先进封装。这里的关键词是CPO——把光引擎和交换芯片封装在一起,进一步缩短电信号路径,是业界公认的下一代形态。孛璞还布局了OIO(光互连芯粒)技术,目标是芯片与芯片之间直接光互联。说白了,就是让GPU之间“对话”不再绕道板级电路。

第三个是硅光智能传感。 基于自研硅光PIC芯片的全固态FMCW光传感方案,集成测距、测速、测振等能力,面向工业检测、无人系统等场景。这条线相对独立,但底层用的是同一套硅光工艺能力。

| 能设计,更能造出来
孛璞半导体官网透露了一些硬信息:公司拥有国内稀缺的量产级硅光全产业链能力,已完成国产12寸CMOS硅光产线工艺与量产验证,实现了100G/lane、200G/lane硅光PIC芯片规模量产。核心工艺包括多波长集成光源、氮氧化硅(SiON)偏振无关工艺、III-V族材料与硅光异质集成、低损耗光波导与高速调制器设计等。
孛璞强调的不只是“能设计”,而是“能量产”。 硅光行业里,实验室做出样品和产线上稳定出货之间隔着不小的鸿沟。团队累计出货超百万颗硅光芯片的背景,以及65项以上核心知识产权(25项已授权),是它敢提“全链路”的底气。
在商业模式上,孛璞除了直接卖产品,还做IP授权与定制开发——依托量产级硅光能力和12寸CMOS硅光工艺验证基线,为光模块、算力与网络厂商提供分层IP授权、工艺移植和联合定制。换句话说,它既自己下场做OCS整机和光引擎,也愿意把底层能力开放给想自建硅光能力的客户。
| 下一步:光,再靠近芯片一点
据孛璞半导体创始人兼总经理邢宇飞的表态,这轮数亿元资金将主要投向三个方向:加大硅光交换芯片及相关工艺的研发投入,推进下一代高速光收发芯片,以及开发面向芯片级光互联(OCI)的光引擎。
不难理解,OCS往更大端口数走,光收发往更高速率走,光引擎往更靠近芯片的位置走。三条线其实指向同一个目标——在AI算力集群里,把“光”从机架之间推进到板卡之间、芯片之间,一步步吃掉原本属于电信号的领地。
当然,硅光赛道并不缺玩家,国内外都有巨头和初创公司在押注。孛璞的差异化在于它同时押了OCS和高速光引擎两条产品线,并且强调量产落地——2025年已实现产品规模出货。
至于这条路能走多宽,最终还要看产品在真实集群里的表现和客户的买单意愿。但至少从技术布局看,它踩在了AI算力互联最疼的那个点上。
是说芯语原创,欢迎关注分享
合作洽谈,进入公众号:服务—>商务合作


