
 五度妙笔
 企业透视镜
 API商城

 数据库
数亿元 Pre-A+ 融资:头部 GPU 与机器人公司一起投 MRAM 推理芯片团队
据光源资本消息,寒序科技已完成数亿元 Pre-A+ 轮融资。本轮除财务投资人外,还引入了头部国产 GPU 公司和头部机器人公司。这类产业股东进入,意味着寒序科技后续可能更早进入产品验证、联合测试和商业化落地阶段。
寒序科技成立于 2023 年,核心团队来自北京大学应用磁学中心,主要围绕 MRAM 研发推理处理器,面向端侧和边缘 AI 推理场景。

| 它想解决什么问题?
大模型推理有一个现实瓶颈:模型部署后,权重基本不变,但每生成一个 Token,系统都要重新读取大量权重。用户感知到的“回答变快或变慢”,背后往往不只是算力强弱,更取决于存储和计算之间的数据搬运效率。搬运本身不产生计算价值,却会消耗功耗、增加延迟。
传统方案各有取舍。DRAM 容量大,但需要周期性刷新,带来额外功耗;SRAM 速度快、无需刷新,但单元面积大,做大容量时芯片面积和成本压力明显。寒序科技选择的是 MRAM 路线:它用磁性状态保存数据,断电不丢失,不需要刷新,单元尺寸也有比 SRAM 更小的潜力。把模型权重放在更靠近计算单元的位置,减少反复搬运,这就是其提出的“权重驻留计算”。
在推理场景中,权重通常只读不写,这与 MRAM 的非易失、高带宽读取特性比较匹配。
| 难点在材料层,也在工程化
寒序科技的特点在于,它不是单纯从芯片架构出发去找存储方案,而是从材料、器件层往上搭。团队长期做凝聚态物理、磁学和自旋电子学,关注的是磁性材料如何稳定读写、器件如何实现低功耗,以及器件如何与推理架构配合。
这种从底层材料到芯片架构的跨层能力,在芯片创业中不算常见。多数团队通常更擅长其中一环,其余环节依赖合作。寒序把最难的材料和器件环节握在自己手里,路径更长,但底层参数也更可控。
目前,寒序科技已完成多颗验证芯片流片,部分回片测试。其验证芯片已完成第三方检测、端到端模型推理验证,并实现连续 24 小时稳定运行。
| FPGA 先行,ASIC 跟进
寒序科技的产品规划分四层推进:底层是 SpinPU-M01,基于 FPGA 的芯片和加速卡,现阶段主要用于验证,也可供早期客户试用;再往上是 SpinPU-M02,也就是真正的 ASIC 芯片,仍在推进流片和工程化,是后续能否规模量产的关键;在此基础上,公司还规划了 SpinPU 与 CPU 组合的异构服务器,以整机形式交付;最上层则是云计算服务,客户无需采购硬件,可直接按用量调用算力。这个梯度安排比较务实:FPGA 方案可以先让客户验证场景,ASIC 流片和量产仍需时间,服务器和云服务则能在芯片大规模量产前,先把商业模式跑起来。
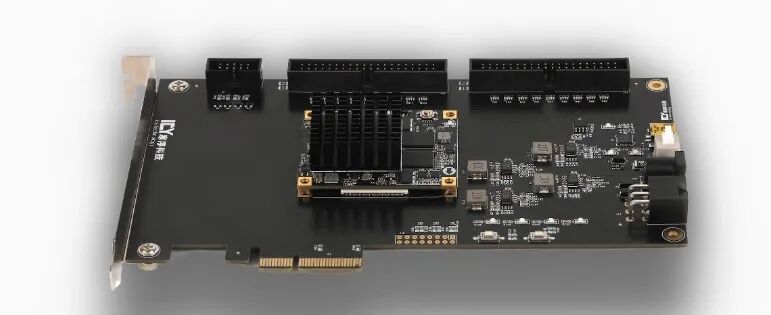
这个梯度安排得比较务实:先用 FPGA 卡让客户摸到产品、验证场景,ASIC 流片的同时服务器和云服务把商业模式跑起来,不至于在芯片量产前的空窗期完全没有收入。
| 产业股东会带来什么
机器人企业更关心模型在整机上能否低延迟响应,机械臂这类场景很难接受云端往返带来的时延;GPU 企业则更关注专用推理能力如何嵌入现有算力体系,补足推理场景的能效短板。
这两类股东的共同价值,是把真实约束条件提前带入芯片设计:目标模型是什么、功耗预算多少、部署环境如何。芯片创业最怕闭门造车,等流片出来才发现和客户场景不匹配,一次试错就可能耗掉一两年。客户在设计阶段就参与进来,能明显降低这种风险。
对硬件创业公司来说,拿到真实场景往往比拿到钱更难。这一轮融资,寒序科技在两方面都取得了一定进展。
| 冷水也要泼一点
MRAM 推理芯片并非只有寒序科技在探索。这条路最终能否走通,取决于量产良率、成本控制、软件生态和系统适配。新存储介质要进入主流量产体系,门槛不会低。
另一个变量是时间。这条路线成立的前提,是端侧和边缘推理需求真正起量,并且功耗约束紧到需要新方案。如果云端算力持续便宜、易用,窗口期可能没有想象中宽。
寒序科技自己也表示,未来一到两年是从技术验证走向规模落地的关键阶段。对材料路线的创业公司来说,样片和客户反馈会比融资额更能说明问题。这轮资金买到的主要是时间,最终能否跑通,还要看接下来一到两年的工程化进展。
免责声明:本文内容基于公开信息及第三方消息源整理,仅供参考,不构成任何投资建议。文中涉及的技术路线、产品规划及商业化进展,不代表对相关公司未来表现的承诺或保证。读者据此作出的任何决策,风险自负。
是说芯语原创,欢迎关注分享
合作洽谈,进入公众号:服务—>商务合作


