
 五度妙笔
 企业透视镜
 API商城

 数据库
这家存算一体公司完成B轮融资,单笔数十亿!
11月初,后摩智能宣布完成B轮融资,单笔金额达数十亿元人民币。过去一年,这家公司已完成多轮融资,此番产业资本、国资与国际投资人同时出现,更像是此前技术验证与商业信号累积后的顺势承接。
| 被逆向选择的赛道
存算一体(Compute-in-Memory)并非新概念,学界研究已有数十年。它的基本逻辑是打破冯·诺依曼架构下"计算与存储分离"造成的搬运开销——在端侧,搬运数据的能耗常常远高于计算本身。
有意思的是产业的走向。
过去数年,绝大多数投身存算一体的公司选择了小算力、超低功耗场景:语音唤醒、可穿戴、传感器端。这条路线商业上稳妥,但天花板也肉眼可见,当大模型成为AI的主角,"端侧AI"的含义发生了变化,能跑推理的芯片才有定价权。
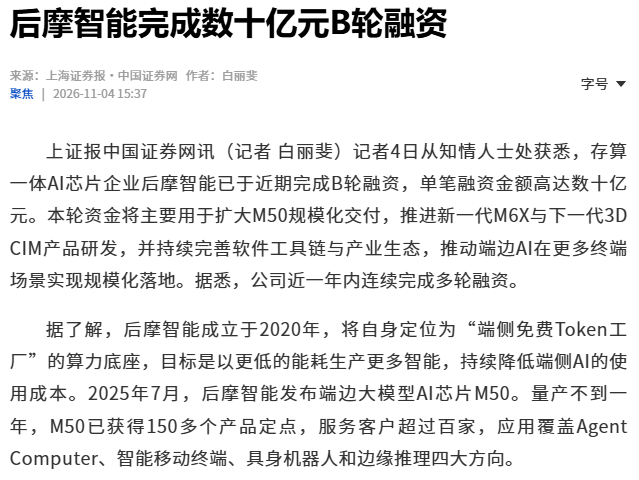
后摩智能在2020年成立时选的是另一个方向:以SRAM-CIM为根技术,直接面向高算力与端边大模型推理。这在当时是一次逆向选择——放弃"容易落地的小市场",去啃"难但大的市场"。按公司披露的数据,采用SRAM-CIM后,其核心计算单元面积压缩至传统架构约30%,功耗降至约10%。数字是否会在真实负载中完全兑现,需要时间验证;但方向上的判断正在被行业接受,在上月刚举行的生态合作伙伴大会上,M50芯片量产不到一年,已获得150多个产品定点、服务超百家客户,这个落地速度在同代创业公司中并不多见。
| 两条路径,一个指标
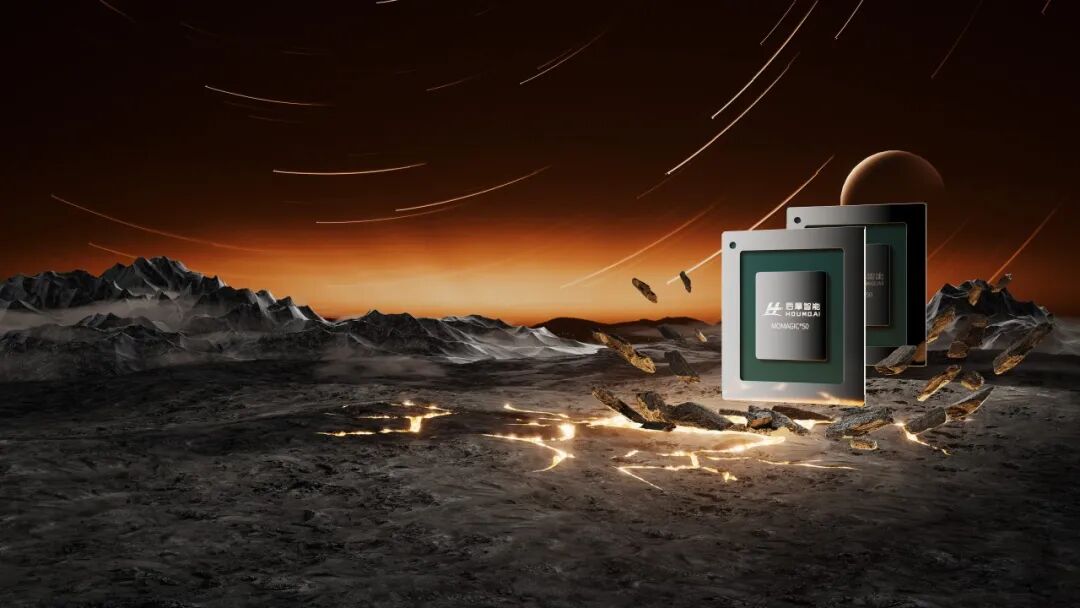
端侧负载对容量和带宽的需求并不相同,后摩因此在同一根技术之上分出两条路径:2D CIM结合SRAM与存储配置,解决"放得下"的问题;3D CIM把SRAM-CIM引入堆叠的逻辑计算层,与先进封装融合,解决"跑得快"的问题,同时应对堆叠带来的散热挑战。
两条路径指向同一个指标:Token/$与Token/W——单位成本和单位功耗下的Token产出。这个提法值得注意。绝大多数芯片公司讲的是TOPS、带宽、工艺制程,而后摩把"每花一块钱、每一瓦电,能产出多少智能"作为北极星指标。这是一种典型的"买方视角":对设备厂商而言,TOPS是采购参数,Token成本才是经营参数。
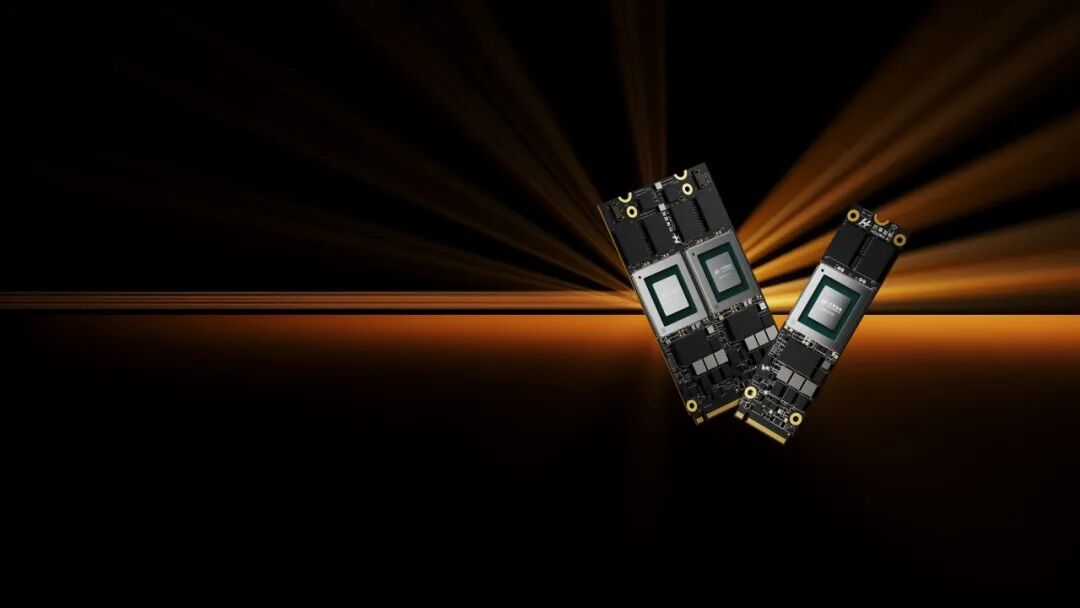
吴强将公司定位为"端侧免费Token工厂"的算力底座。"免费"当然是一种修辞——真正的含义是,当端侧Token成本被压得足够低,它将趋近于用户感知为零,AI才会像水电一样嵌入终端。这个逻辑成立与否,取决于M50、首颗3D CIM芯片A20以及在研的M6X能否持续兑现能效优势。目前看,M50的160 TOPS@INT8、10W典型功耗,使其可以覆盖从8B级到近千B级模型的本地化运行需求(后者需多芯系统),产品矩阵的台阶是清晰的。
| 软件:被低估的第二战场
对存算一体公司而言,真正的考验往往不在芯片而在软件。新架构意味着新编译器、新算子库、新适配成本——开发者没有理由为了一条非主流路线付出额外学习成本。这是历史上多种新架构芯片折戟的共同原因。
后摩的选择是开源"后摩AI生态软件",覆盖量化、编译、推理部署到应用开发的工具链,计划于2027年1月前陆续上线。一个务实的细节是:这套工具链很大程度上来自150多个定点项目中沉淀的共性问题——也就是说,它不是一份前瞻性规划,而是被真实客户需求打磨出来的产物。把适配经验开源化、标准化,本质上是在降低伙伴的切换成本,这也是新架构芯片公司构建生态时最有效的一步棋。
| 几点观察
客观地说,后摩的叙事仍有几处需要时间检验:
其一,量产规模与良率。150多个定点是订单信号,兑现为稳定大规模交付还需经历供应链与产能的考验,本轮资金的主要用途也正在于此。
其二,3D CIM的工程复杂度。A20已投产是好信号,但3D堆叠的散热、良率与成本控制是行业级难题,量产爬坡仍存不确定性。
其三,生态竞争的窗口期。GPU大厂与大模型厂商都在向端侧延伸,后摩的能效优势需要持续拉开足够差距,才能抵消通用生态的惯性吸引力。
| 结语
资本密集加码,说明市场开始相信一件事:端侧AI的竞争终局不在算力军备赛,而在成本效率赛。后摩智能用六年时间把一条冷门路线做到量产与百余家客户,这本身已构成对中国芯片创新的一种样本意义。但"Token工厂"的愿景能否成立,最终不由融资决定,而由下一代产品决定——M6X与3D CIM的量产表现,将是这份账本最关键的下一页。
免责声明:本文依据公开报道及企业披露信息整理,仅供信息分享与行业观察,不构成任何投资建议或产品采购依据。文中数据(融资金额、定点数量、芯片参数等)均来自公开渠道,未经独立核实,可能存在口径差异或更新滞后,作者不对其准确性与完整性作保证。文中观点为作者个人判断,具有时效性,不代表任何机构立场。
编辑:是说芯语-W²
是说芯语原创,欢迎关注分享
合作洽谈,进入公众号:服务—>商务合作


