2nm CPU全面开卖!单机架跑7.3万智能体,用AI让内存成本腰斩 发布时间:2026-11-12 来源:芯东西
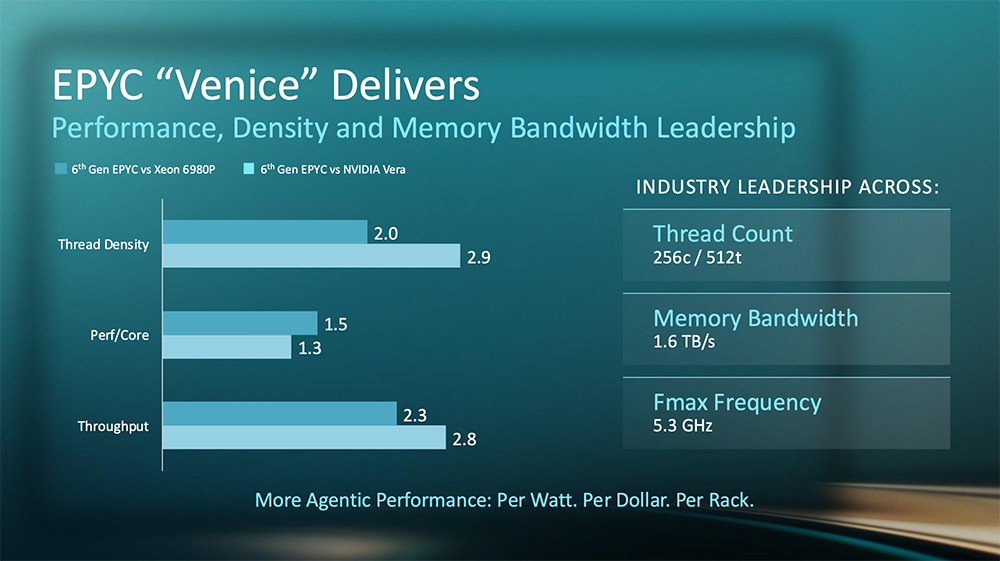
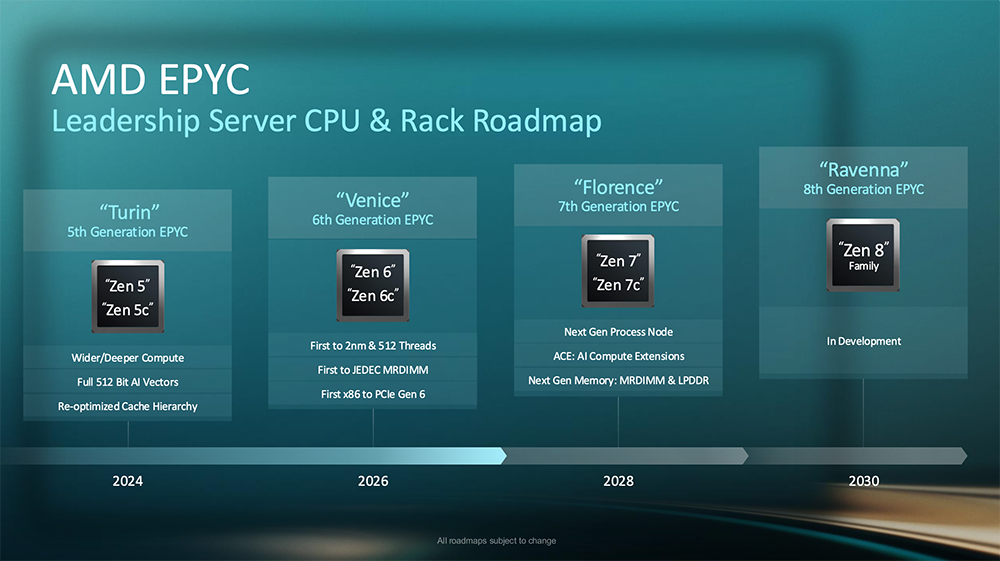
深度揭秘第六代AMD EPYC服务器CPU技术细节。 芯东西11月12日报道,进入11月,AMD喜讯不断,上周最新财报披露Q3数据中心收入接近乎翻倍,这周股价连续走高,三天上涨超13%。 昨天,AMD宣布采用SP7封装的第六代EPYC 9006 SP7服务器CPU “Venice”全面上市,首批AMD Helion智能体AI机架将于本月陆续上市。 在Q3财报电话会议上,AMD董事会主席兼CEO苏姿丰博士称,“Venice”芯片的早期需求是EPYC历代新品中最强劲的。 AMD在第三季度开始交付“Venice”处理器,OEM和ODM合作伙伴承诺推出超过240款平台,比第五代“Turin”多出20%,云实例计划于2027年初陆续上线。 那为啥“Venice”卖得这么好呢?这次AMD技术大佬们也不藏了,上周在拉斯维加斯的一场闭门技术会上,把第六代EPYC服务器CPU的设计目标和技术细节里里外外讲了个遍。芯东西在现场足足整理了六万字笔记。 从智能体AI时代需要什么样的CPU,到为什么要做四款不同配置的CPU,再到“Venice”的架构细节,包括SoC架构、微核心架构、内存、I/O、功耗管理等创新技术,AMD高管和技术专家们讲得非常深入,并花了很长时间来讨论如何降低内存成本,信息量爆棚。 AMD迄今已发布六代服务器CPU,从2018年推出的初代“Naples”到第六代“Venice”,性能提升多达 近20倍 。 “Venice”最多提供256核、512线程、1.6TB/s内存带宽、5.3GHz运行频率,计算Die采用2nm制程工艺。 与英特尔至强6980P、英伟达Vera CPU相比,“Venice”的线程密度、每核性能、吞吐量都显著提升,因此能提供更高的每瓦、每美元、每机架智能体性能。 据AMD现场分享,今年年初,其服务器CPU市场份额还处于40%出头的水平,如今已攀升至40%中段;大多数美国财富100强企业都在数据中心采用EPYC处理器。 AMD还披露了未来路线图,第七代 “Florence” 将于2028年发布,同样采用两种核心路线,将采用下一代制程工艺和内存,并将AI计算扩展(ACE)推向市场;第八代 “Ravenna” 也已经在开发中。 如今智能体AI计算需求爆炸式发展,新一代AI基础设施已是算力厂商的兵家必争之地。“Venice”凭什么承载起AMD进一步扩张服务器CPU疆域的雄心? 本文对第六代AMD EPYC服务器CPU的技术细节与产品亮点进行了精编,按如下章节分享: 2、智能体AI、云计算、HPC与垂直市场性能对比。 4、“Venice” SoC:CCD、I/O Die与数据通路。 7、内存:DDR5、LPDDR5X、CXL 3.1。 9、I/O:PCIe Gen 6与SDXI数据搬运引擎。 10、功耗管理:DFP、UPP、UBPS、FAST。
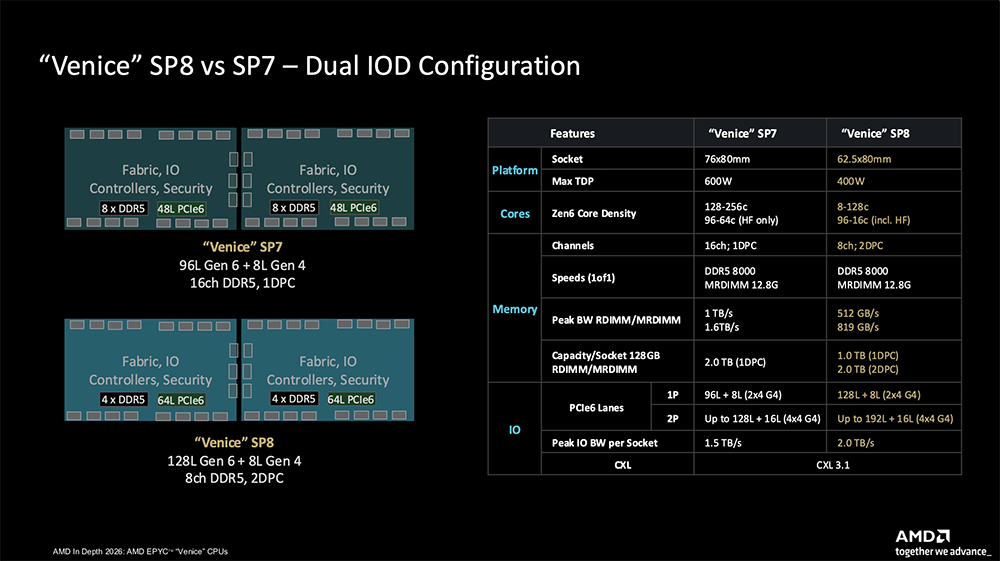
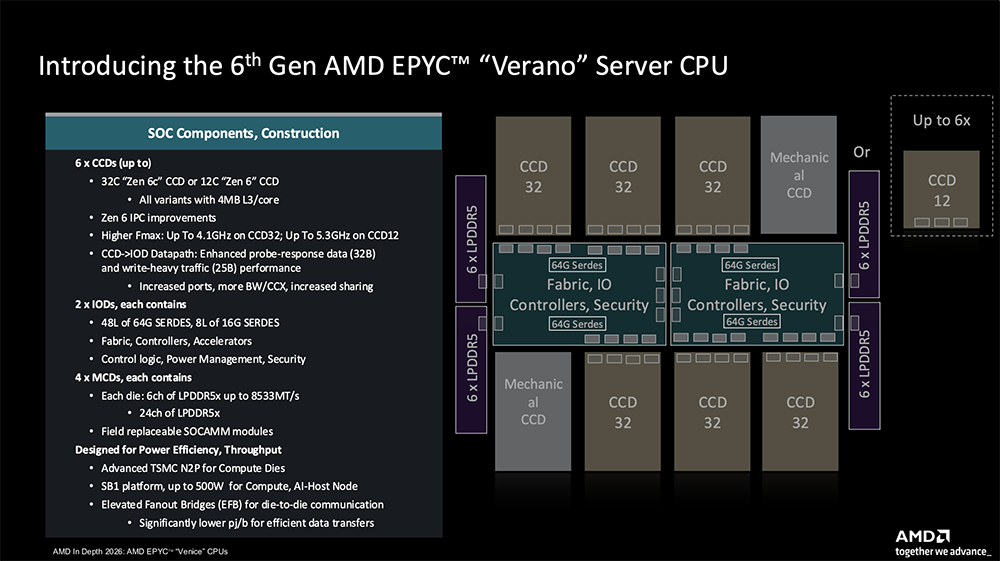
第六代AMD EPYC服务器CPU产品组合共有四款产品,包括“Venice” SP7、“Venice” SP8、“Venice-X”和“Verano”,分别面向不同的工作负载计算需求。 (1)“Venice” 9006 SP7 :旗舰产品,面向高计算吞吐需求,采用紧凑型插槽设计(76 x 80mm),高密度Zen 6c配置最多256核和512线程、4.1GHz频率,高频Zen 6配置最多96核和192线程、5.3GHz频率;支持单路和双路部署,单路最多提供96条PCIe Gen 6通道,单通道带宽是上一代产品的2倍;支持符合JEDEC标准的MRDIMM-12800,每插槽可提供1.6TB/s内存带宽;处理器功耗可配400–600W。产品已开始出货。 (2)“Venice” 9006 SP8 :面向计算需求相对适中、重视I/O能力和成本效率的企业级市场,尺寸比SP7更小(62.5 × 80mm),配备全新I/O Die,最多配置128个Zen 6c核心或96个Zen 6核心,支持8通道内存,每通道可装两条DIMM,每个插槽提供128条PCIe Gen 6。产品将于2027年上半年上市。 (3)“Venice-X” 9006X SP7 :面向对大容量L3缓存敏感的HPC工作负载,搭载3D V-Cache,用堆叠缓存换更少的内存访问,最多配备96核,L3总缓存量最多可达1152MB。产品将于2027年下半年上市。 (4)“Verano” 9006 LP :面向AI主机节点,采用24通道LPDDR5X,可降低非CPU核心部分的功耗,通过可更换的SOCAMM内存模组提供内存,降低内存侧功耗。产品将于2027年下半年上市。 虽然“Verano”采用BGA封装,而“Venice” SP7采用SMLGA插槽,但从逻辑架构来看,CCD与I/O Die之间的数据通路得到了完整复用。因此,“Verano”能提供与SP7相同的核心级性能能力。 “Venice” 9006 SP7服务器CPU的型号如下。其中“F”代表高频型号,采用Zen 6核心。 不同市场对性能、能效和计算密度的关注重点不同,因此“Venice” CPU架构需对不同运行区间进行优化。 下图中,纵轴代表性能,横轴代表功耗。图中标注的15%~100%利用率,指的是SoC整体的核心活跃比例,也就是同一时间有多少CPU核心正在运行。 右侧的HPC和主机节点工作负载非常重视单核心峰值性能,往往具有突发性,同时对延迟较敏感,因此CPU必须具备足够宽的动态运行范围,所以AMD利用更先进的制程工艺把核心的最高运行频率拉到5.3GHz。 另外两个工作负载是云计算和Agentic-Bulk。当CPU核心利用率下降时,功耗预算可以集中到正在运行的核心上,CPU核心必须具备足够宽的频率和功耗调节范围,才能将这些额外功耗转化为相应的性能提升。因此Zen 6c核心需要具备最高4.1GHz的运行频率。 如果将SoC功耗预算进一步降低至400W,设计重点已经转向计算密度。在这个运行区间,AMD更关注每兆瓦能提供多少线程、每瓦功耗能提供多少计算性能。
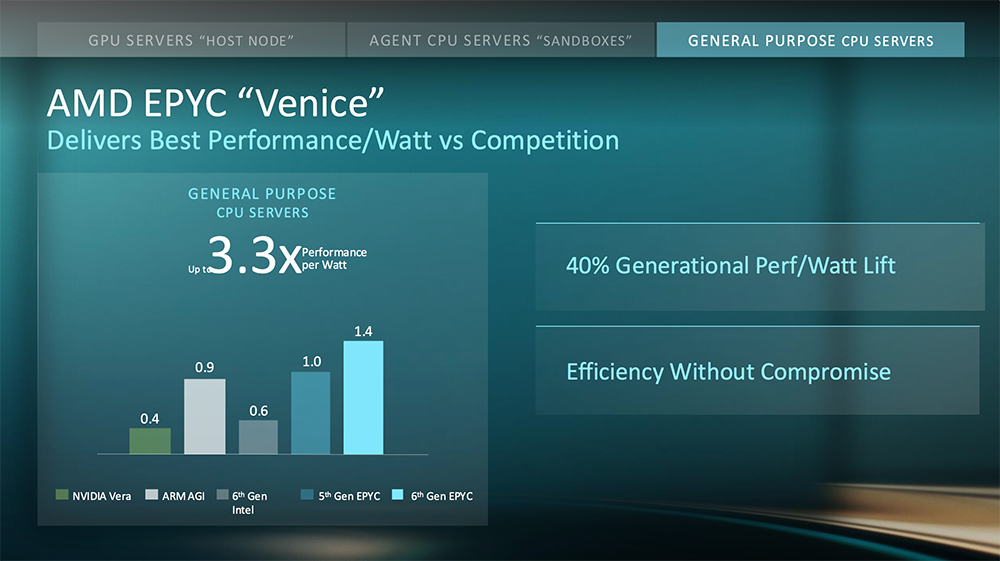
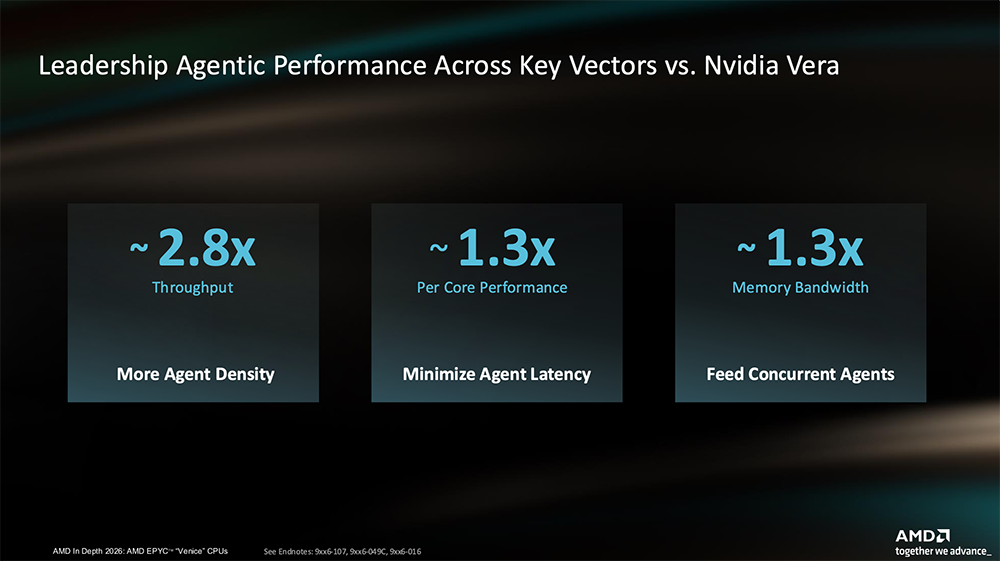
AMD将EPYC 9006 SP7服务器CPU定位为“面向智能体AI时代的最佳CPU ”,为智能体AI基础设施涵盖的三类CPU( 通用服务、AI主机节点、智能体沙箱 )都设计了针对工作负载优化的处理器。 (1)在通用计算 测试中,“Venice”的每瓦性能相较上一代提升 40% ,是英伟达Vera、Arm AGI、第六代英特尔至强等CPU的 约1.5倍-3.5倍 。 (2)高达5.3GHz的高频主机节点处理器 可提供多达上一代 1.6倍 、第六代至强 1.8倍 的大语言模型输出吞吐量。 (3)高密度AMD EPYC处理器在托管智能体沙箱 方面,每CPU瓦特的智能体数量是英伟达Vera的约 3.3倍 、英特尔至强6980P的约 2.5倍 。 对于智能体沙箱 ,基于AMD EPYC 9996 CPU的服务器在相同35千瓦功耗范围内,每个机架可支持的智能体数量约是使用默认电源管理设置的系统的 1.18倍 。 为什么是“最佳”?AMD称,“Venice”在 Token经济性、每美元Token产出、最高智能体承载数量、每瓦智能体承载能力 等方面均有领先表现,同时也是世界上能效最高、每瓦性能最出色的智能体AI CPU 。 相比上一代,AMD EPYC 9006 “Venice”服务器CPU在整数计算、浮点计算、内存带宽、高性能计算、矩阵计算工作负载的性能提升多达 1.3倍~2.7倍 。 对于智能体AI应用,模型调用、检索、路由、文档解析、代码编译和沙箱执行都会占用CPU。 AMD将智能体流程拆开来测试,对比英特尔至强6980P,在多数情况下,“Venice”的性能至少达到 2.4~2.8倍 ;在tokenize和编排方面,“Venice”的性能达到 3.5倍 。 与英伟达Vera公开数据相比,在双方都使用各自最优编译器的比较口径下,“Venice”可提供 2.8倍 的吞吐量、 1.3倍 的每核性能和 1.3倍 的内存带宽。 从智能体AI的安全需求来看,AMD正在安全生命周期、威胁覆盖范围、基础安全能力、远程证明和身份验证、机密计算等多个层面建立相应能力。 面向企业和云服务应用,基于AMD EPYC 9996 CPU的系统,与基于英伟达Vera CPU的系统相比,性能最高可提升至 3.7倍 ;与基于英特尔至强6980P的系统相比,性能最高可提升至 2.2倍 ,性价比最高可提升至 2.0倍 。 微软Azure宣布预览基于“Venice”的 HDv2实例 ,成为首个提供第六代EPYC的云服务商。 对于 高性能计算(HPC) 工作负载,根据已发布的SPECrate基准测试结果,“Venice”凭借高内存带宽和领先的计算性能,能够帮助缩短生命科学、量子化学和天气预报等领域复杂模拟的洞察时间。 在AMD展示的单节点测试中,对比英特尔Granite Rapids,“Venice”的SPEC HPC 2021性能达2.3倍 ,STREAM测试性能达 2.2倍 。 在有限元分析、计算流体力学、SPICE电路仿真、天气预测等工作负载中,“Venice”相比竞品都实现了显著的性能提升。 在 垂直市场 ,企业客户购买的并不只是一颗CPU,而是解决业务问题的方案。 面向数据中心现代化,相对于当前已部署的英特尔至强Ice Lake系统,迁到“Venice”可帮客户将服务器数量最多减少 86% ,并将五年总拥有成本降低 37% 。 同时,“Venice”非常适合用于存储基础设施,能够实现约为第六代至强方案 3.3倍 的存储和数据库吞吐量。 与第六代英特尔至强相比,Databricks使用“Venice”,在SQL事务处理方面实现略高于 2.6倍 的性能表现,NoSQL性能则达到 3.5倍 ,在一组智能体AI工作负载中性能提升多达 2.7倍 。 相较上一代,运行金融开源库QuantLib时,“Venice”的总吞吐量提升约 80% ,按单位功耗衡量,可完成的任务数量增加了约 50% ;运行NUMPY和SCIPY开源库时,“Venice”单台服务器的平均性能达到约 2.1~2.3倍 。 在制造业,相比上一代,“Venice”运行不同工业软件时性能提高至 1.3倍~1.6倍 。 在电信业,“Venice”可实现相对于上一代约 3倍 的单位功耗流量处理能力,也就是说在相近功耗下能处理 3倍 的流量,从而逐步降低运营商的运营成本。 在医疗业,从第六代英特尔至强平台迁到“Venice”后,运行分子模拟任务可实现 3倍 的性能。
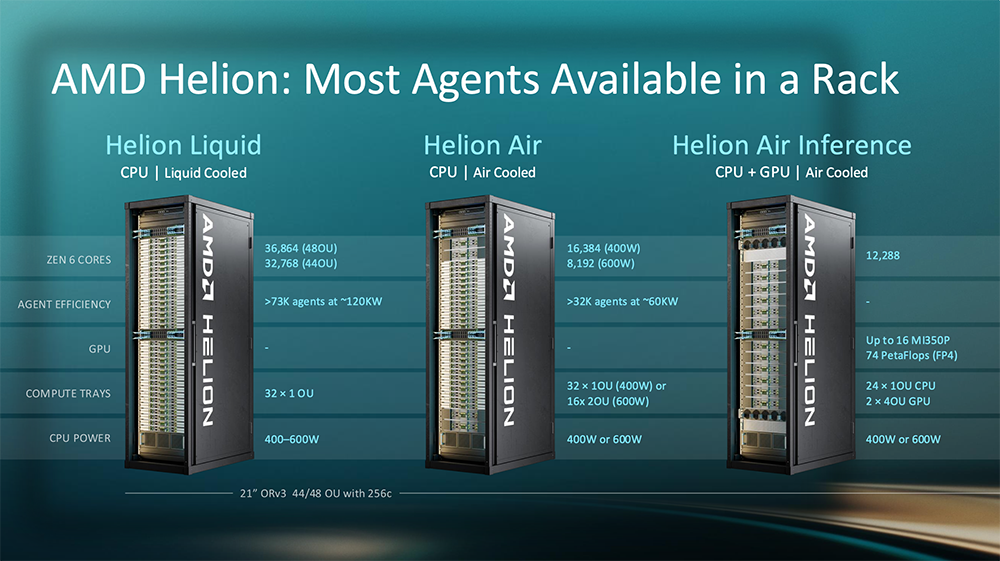
“Venice”旨在成为最出色的智能体AI CPU,高密度Helion智能体AI机架则负责将这些领先能力整合起来,为客户交付完整解决方案。 跟英特尔、Arm AGI,英伟达Vera机架相比,“Venice”依然表现得赢麻了,提供了最多的 73728个线程 。 (1)Helion Liquid :专为与AMD Helios机架级解决方案并肩部署于大规模智能体AI环境中而设计,拥有最高的智能体密度,机架功率为120kW,单柜可容纳36864核、73728个线程,运行超过73000个智能体。 (2)Helion Air :扩展风冷数据中心的智能体容量,在约60kW机架功率下可提供1.6万个以上的核心,承载超过32000个智能体。 (3)Helion Air Inference :将CPU执行和本地GPU推理集成于同一机架中,本地同时跑模型和工具。 如果客户希望在供电受限的机架中运行更多智能体,AMD提供了一项 统一功率配置 功能。它可以在CPU和内存之间统筹功率,动态分配功率预算;当内存需要更多功率时,可以对CPU进行功率限制。启用这项功能后,在相同功率预算下可获得20% 的性能提升。 AMD Helion智能体AI机架通过开放的智能体AI基础设施蓝图,把灵活性交给客户。客户可根据自身基础设施的需求,选择合适的CPU和GPU容量、散热和连接方式。 用于智能体沙箱的服务器CPU配备了 ROCm Agentic Toolkit智能体工具包 ,可在Helion上管理会话、调度任务,并用进程级或虚拟机级沙箱隔离工具,帮助客户简化部署和扩展智能体AI的过程。 目前AMD已有超过10款通过Helion认证的机架。首批Helion机架将从今年11月开始上市。
在设计“Venice”时,AMD确立了一些明确目标:实现最高吞吐量、最低总拥有成本(TCO)、最佳能效,同时保留AMD一贯重视的企业级功能。 Zen 6 核心是整颗“Venice” SP7 SoC的基础。这些核心以 核心计算Die(CCD) 的形式集成到SoC中,最多有8颗CCD,通过2颗I/O Die连接到整个系统。 Zen 6主打单核性能,Zen 6c主打核心密度,两者共享同一套核心逻辑和x86指令集。 高频Zen 6 CCD集成 12核 ,高密度Zen 6c CCD集成 32核 。每颗SoC最多可以集成8个CCD,因此高频Zen 6版本最多提供 96核 ,而Zen 6c版最多可提供 256核 。 两种配置均支持 同步多线程技术(SMT) ,分别提供最多 192个线程 和 512个线程 。 CPU核心之外的相关功能模块主要由 I/O Die 承担。2颗I/O Die采用同一设计,在封装里相互旋转180度。每颗有8个DDR5通道、48条PCIe 6.0通道,并集成控制逻辑、电源管理模块、I/O Hub、安全微控制器等组件。 第五代Infinity Fabric 负责把请求送到目标CCD、内存控制器或I/O端口,管理流量和服务质量,并通过大量控制器及Fabric路由机制,确保CPU核心能够及时获得数据,同时让不同数据流达到所需的性能水平。 为确保核心获得足够的数据供给,“Venice”还增加了 SDP可扩展数据端口 的数量,32核CCD配备4个SDP端口,12核CCD则配备3个SDP端口。每个SDP能够提供每周期32B的读取带宽,以及每周期16B的写入带宽。 同时,AMD也在封装层面重新考虑了CCD与I/O Die之间的连接方式,采用 EFB先进扇出桥接 技术,把Die之间的距离缩短至几百微米,以降低功耗与延迟。 其体封装过程是:在玻璃载板上形成铜柱,放置桥接芯片,进行塑封,随后构建RDL重布线层,将信号引导至微凸点,并在这些位置安装有源芯片,最后将重新构建的封装模块切割分离,形成独立封装单元。 两颗I/O Die还带来一个调度问题:线程和数据放在哪一侧,会影响访问路径。 NPS(Nodes Per Socket,每插槽节点数) 是一种通过固件来管理系统拓扑和内存交织方式的机制,会创建多个邻近域,将一定数量的计算资源、内存资源和I/O资源组合到同一个域中。 NPS1 把内存访问交织到全部16个通道,适合难以精确控制线程与内存放置的系统; NPS2 按I/O Die划出两个 NUMA域,每域最多128核、8个内存通道,单域搭配满速MRDIMM能提供约819GB/s的理论带宽,甚至超过了上一代“Turin”整颗SoC的内存带宽; NPS4 进一步细分资源,适合在一个插槽内并行运行多个独立实例。 随着SoC规模不断扩大,NPS2所提供的计算资源和内存资源规模已经足以构成一个具有实际价值的计算单元。
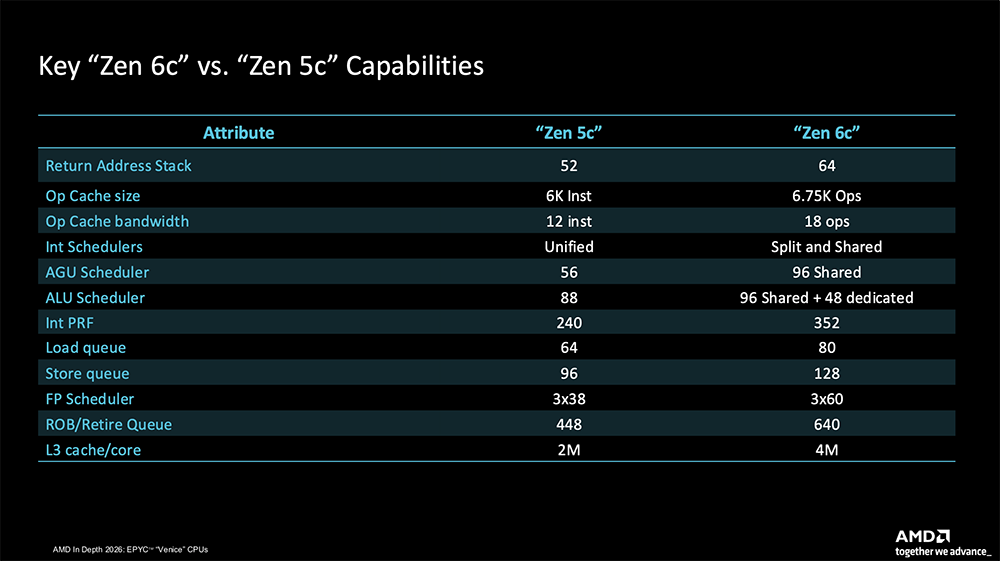
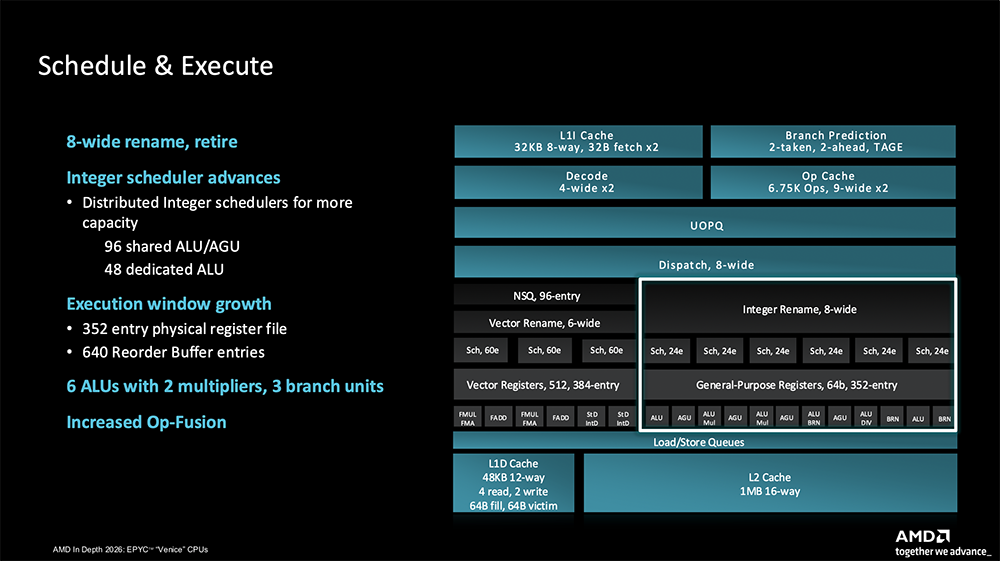
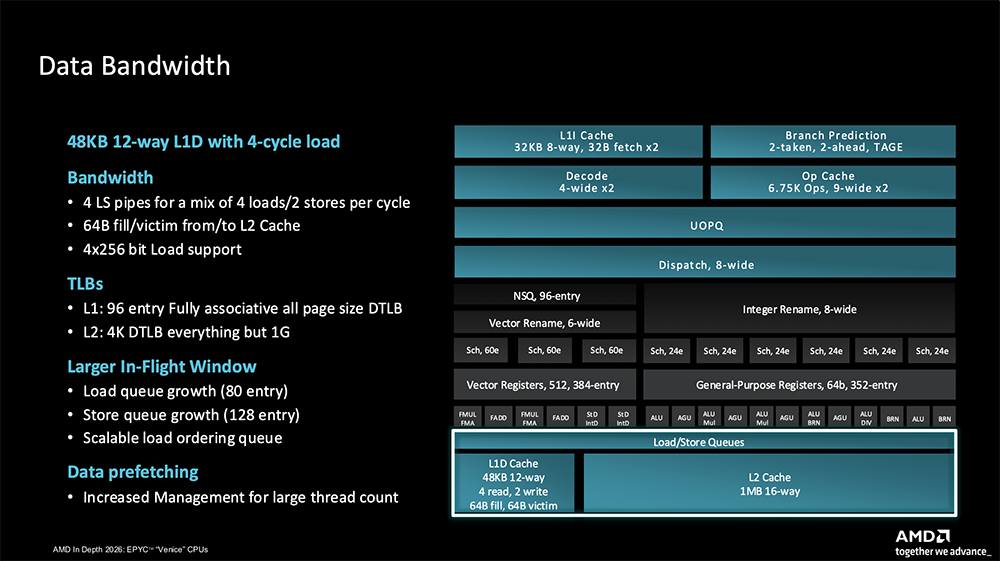
微架构设计有4个关键因素:频率、IPC、功耗和面积。它们之间存在各种权衡,相互制约。 从Zen 4开始,AMD逐步开发能让不同CPU核心实现差异化的技术。Zen 6系列核心则进一步强化了5个目标: AMD一直在优化频率和IPC之间的关系,对面向横向扩展的 Zen 6c 核心设定了较低的频率目标,因此可在核心内部增加某些资源,从而提供更高的IPC。 相比Zen 5,Zen 6的CCD核心数增至 12核 ,最高频率提升至 5.3GHz ,L3缓存增至 48MB ,核心数最多 96核 。 相比Zen 5c,Zen 6c的CCD拥有翻倍的 32核 ,可将更多工作负载完整放入单个CCD中;每核心L3缓存翻倍至 4MB ,对应单个CCD中的L3缓存增至 128MB ;最高频率提升至 4.1GHz ;核心规模最多 256核 。 一个较大的虚拟机或共享数据的多线程任务,更容易放在同一个缓存一致性域内。 在固定频率、采用轻负载测试方法的情况下,相较Zen 5c,Zen 6c的企业级和云服务器工作负载IPC平均提升 20% 左右,AI工作负载IPC平均提升约 31% ,综合IPC平均提升约 27% 。 总体来看,相比Zen 5c,Zen 6c主要有如下改进: (2)微操作缓存(Op Cache)从6K增至6.75K操作。 (3)微操作缓存带宽从每周期12条指令增至18个操作。 (4)整数调度器从统一式转向分布式和共享式设计,重新划分资源,让AGU与ALU共享部分调度器,共享调度器共96项,由于整数计算需求更高,还为ALU单独配置了48项专用调度条目。 (5)整数物理寄存器文件从240项增加到352项。 (9)重排序缓冲区(ROB)从448项增加到640项。 (10)平均每核心L3缓存容量从2MB增至4MB。 Zen 6c对 分支预测 进行了大量优化,提高准确率并降低延迟,还增强了 微操作融合 能力,能将两条指令融合为一个微操作,让部分指令只占用一次调度和结果转发。 这能同时带来显著的性能和功耗收益。即使ROB的物理容量没有变化,通过微操作融合也能够容纳更多指令。 在 数据缓存 方面,Zen 6对 带宽、TLB(地址转换后备缓冲区)、指令窗口、数据预取 都做了优化。 出于能效方面的考虑,L3与L2之间的数据传输带宽仍然是每周期32B,L2到L1的带宽为每周期64B。 L1 TLB对所有页面大小都采用全相联设计,能应对各种不同的软件代码和内存访问模式;L2 TLB拥有容量非常大的4KB页面数据TLB,支持除1GB页面之外的其他页面大小;对于1GB页面,提供有单独的TLB。 低线程数和高线程数对预取激进程度的要求不同。对此,AMD投入了大量精力来调整预取算法 ,让它能够根据客户实际调度到CPU核心上的工作量,以及这些工作负载的变化情况,动态调整预取策略。 缓存层级结构 方面,Zen 6和Zen 6c基本架构特性大致相同,在队列容量等方面有些差异。 与前代不同,Zen 6c能提供完整的每核心4MB L3缓存。此外,32核心复合体内部保持完整的缓存一致性,保留影子标签机制,L3采用牺牲缓存设计,接收从L2逐出的数据,也能借助影子标签查到数据是否在另一个核心的缓存里。这样,即使请求核心的缓存未命中,也有机会在核心复合体内拿到数据。 对于32核版本,一个核心复合体最多可同时处理1280次从L3到内存的未完成命中请求。而在12核、48MB L3版本中,该数量降为480次。 全片高负载时,预取策略还会收敛,避免无效预取挤占带宽。
每推出一代新产品,AMD都会推动x86指令集进化。 全新 Zen 6指令集 增加了完整的FP16支持,还引入了英特尔此前在AVX方面增加的一些指令,包括VNNI INT8 相关指令和部分数据类型转换指令,并扩展部分AVX指令与VEX编码的IFMA支持。 AMD保留了每周期两次512位加载,同时支持 每周期4次256位加载 。这样一来,已经用上256位AVX、又难以进一步向量化的代码,也能更充分地使用加载通路,提高吞吐量。 在浮点计算方面,Zen 5对F16仅支持格式转换操作,也就是必须先把数据转成FP32,进行运算,再将结果转换回FP16,这个过程会产生额外的转换开销。 而Zen 6和Zen 6c加入了完整的 AVX-512 FP16计算支持 ,因此相关工作负载可直接执行FP16运算。 AMD还将用于AI工作负载的 VNNI INT8执行流水线 从Zen 5中的2条扩展到Zen 6中的4条。 同时,Zen 6新增了一个指令集功能 BMM(Bit Matrix Multiply,位矩阵乘法) ,可执行位级操作,支持密码学算法、AI工作负载及其他位操作算法。 高频Zen 6的浮点调度器有46项 ,Zen 6c有60项 ,这正是两种物理设计的区别之一。前者给高频留出空间,后者可以用更大的窗口挖掘并行性。 在内核/虚拟化方面,Zen 6增加了一个新的 用户态与内核态接口FRED ,用于处理中断、异常和系统调用,可提供更高性能、更好的安全性,同时让操作系统和虚拟化软件开发者更容易使用。 性能分析也有改动。Zen 6指令集增加了一个独立的 内存性能分析器 和 IBS硬件缓冲 功能。内存性能分析器包含一组专用寄存器和跟踪机制,可监控内存系统中的活动;借助IBS缓冲功能,处理器可自动将采样结果写入内存缓冲区,减少逐样本触发中断的开销。
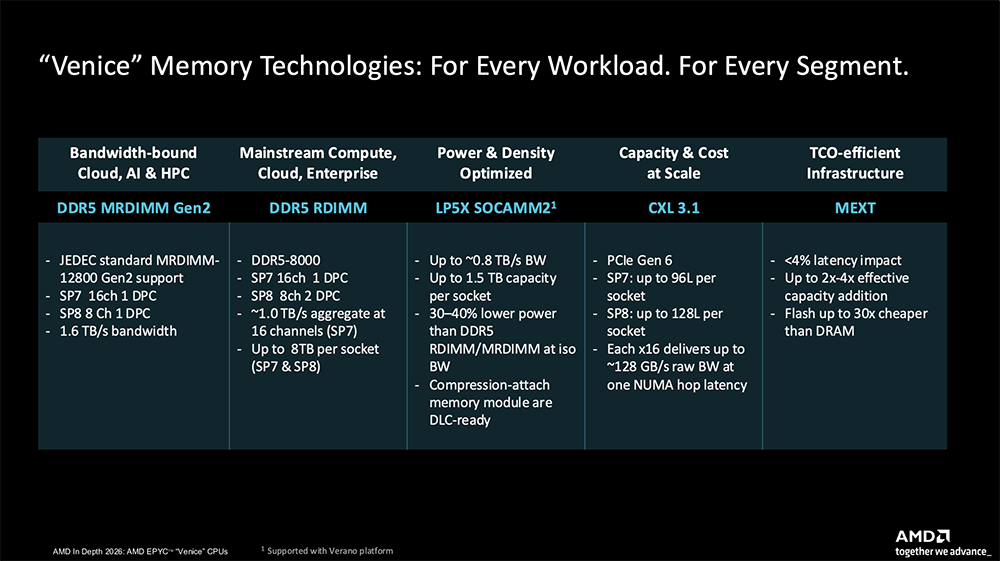
首先是 DDR5 。SP7的16个DDR5通道采用1DPC,每通道支持1条DIMM,即1DPC配置。DDR5-8000 RDIMM 满通道理论带宽约1.02TB/s,12.8GT/s MRDIMM 可达约1.64TB/s。16条512GB DIMM对应最高8TB容量。 “Verano”则提供注重能效的 LPDDR5X 配置,将内存接口拆到4颗独立的内存Die上,每颗6个通道,合计24个通道、768位接口,采用可更换的 SOCAMM 模组。计算Die用N2工艺,内存Die用N3工艺,I/O Die用N6工艺。 对于希望把SoC功耗压到400W以下的主机节点,降低内存相关功耗能给计算核心留出更多预算。 CXL 把设备后面的内存映射进系统地址空间,可做容量扩展、软件分层或交织。在当前内存价格受到明显压力的市场环境下,客户可以重新利用在旧DRAM技术上的投资,通过CXL以合理成本实现TB级内存容量扩展。 “Venice”的全部96条PCIe通道都同时支持CXL。用户无须提前配置,只要插入设备,系统就能自动识别它属于PCIe还是CXL。平台的服务质量(QoS)机制可区分本地DDR和CXL流量,降低两者互相争抢带宽的影响。 MEXT 是今年6月刚被AMD收入麾下的一项内存优化技术,通过将闪存作为一个内存层级,旨在解决内存浪费问题,降低内存成本。这是在本次技术活动最受关注的技术,没有之一。
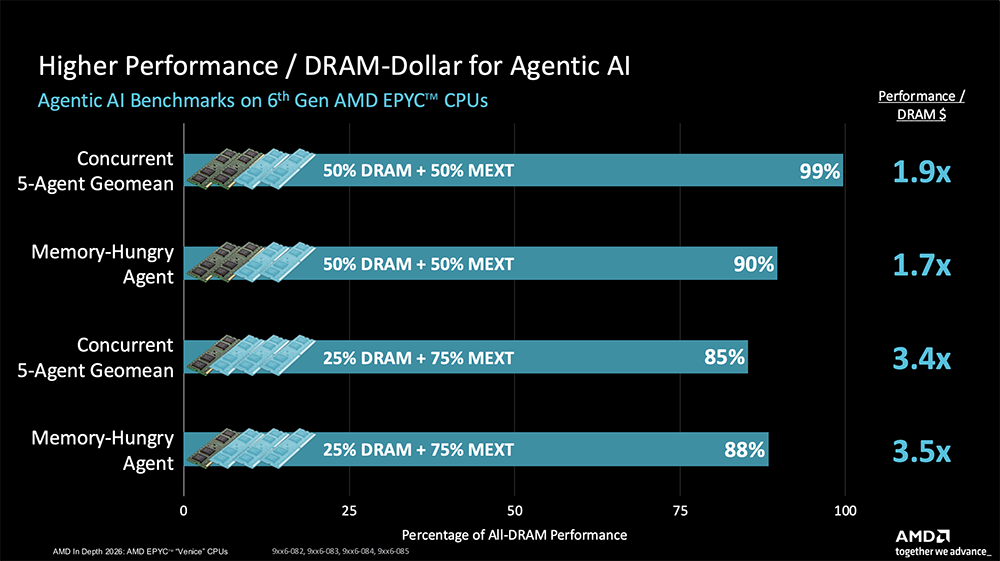
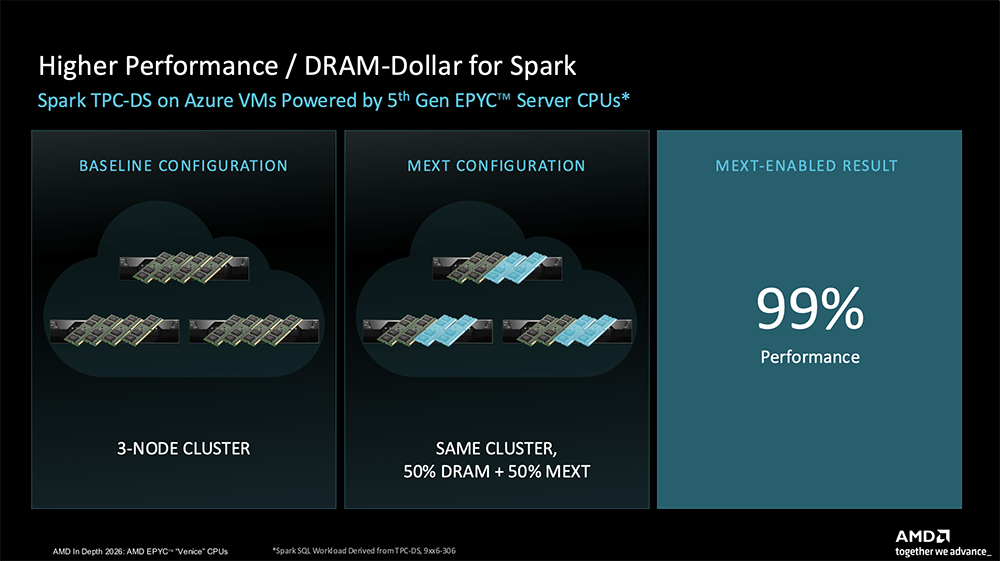
MEXT团队早在2024年就开始与AMD合作。当时AMD想要增加可用内存容量,在内部145台系统采用MEXT内存扩展技术后,其节省的DRAM采购成本多达 490万美元 ,占单系统成本的 83% 。 MEXT的技术思路是,利用AI监控系统运行状态,提前预测哪些内存页面即将被访问,然后在应用程序真正需要这些页面之前,主动将它们从闪存迁回DRAM。 也就是说,通过透明化的软件机制,让闪存表现得像DRAM一样。 为什么选择闪存?因为从单位比特来看,相比DRAM,闪存的成本低至约 1/50 、功耗低至约 1/30 ,但访问速度慢到只有DRAM的 1/500 。 这套方案完全由软件实现,包括 Linux驱动程序 、 AI引擎 和用于观察系统内存实际使用情况的 RAMView工具 。 据分享,MEXT成功做到只需 一个 EPYC CPU核心,就能在不到 1秒 内完成训练,并开始进行高质量预测。随着运行时间增加,预测效果还会继续改善。 它的好处非常直观,能够显著降低服务器DRAM成本。 假设你原本计划购买一台配置2TB DRAM的EPYC服务器,现在就只用买1TB DRAM,另外 1TB 内存容量则由MEXT解决方案提供。 这里还有第二层收益。为了实现2TB DRAM容量,你可能需要采购昂贵的256GB DIMM内存条。但如果改用128GB DIMM,其成本远低于256GB DIMM的 一半 。 因此你不仅减少了所需的DRAM总容量,还能买价格更低的DIMM。 此外,MEXT能够扩展服务器的可用内存容量。例如,一台原本配置1TB DRAM的服务器,可通过软件和NVMe闪存扩展,让系统呈现出1.2TB、1.5TB、2TB、3TB甚至4TB的内存容量。 这些技术的应用面很广,能部署在企业本地数据中心、云端、虚拟机、裸金属服务器上,也支持容器环境。 新采购的和已部署的EPYC服务器,都能用这项技术。服务器需要配备NVMe闪存盘,或者至少预留未来安装NVMe闪存盘的空间。 AMD MEXT软件希望实现的效果如下图所示,从完整DRAM配置开始,逐步减少25%、50%,以此类推。 在智能体AI、数据库分析和EDA工作负载中,MEXT能够将DRAM容量减少 一半 ,同时实现接近全DRAM配置的性能。 在5种智能体工作负载中,通过采用MEXT软件,在将DRAM容量减少 一半 的情况下,应用性能能达到原来的 99% 。 即便DRAM容量减少到原来的 1/4 ,MEXT仍能使其保持相当不错的性能。 在“Venice”上运行Synopsys PrimeTime EDA工具,同样将DRAM容量 减半 ,MEXT能保留全DRAM配置 95% 的性能。 在微软Azure云平台上运行Apache Spark数据处理引擎,将DRAM容量 减少一半 后,MEXT使其性能达到原配置的 99% 。
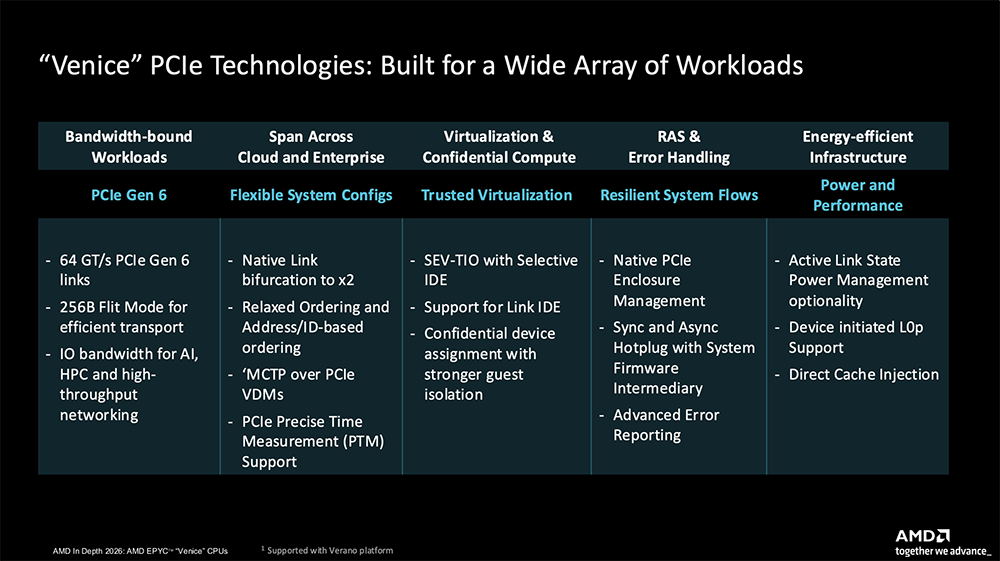
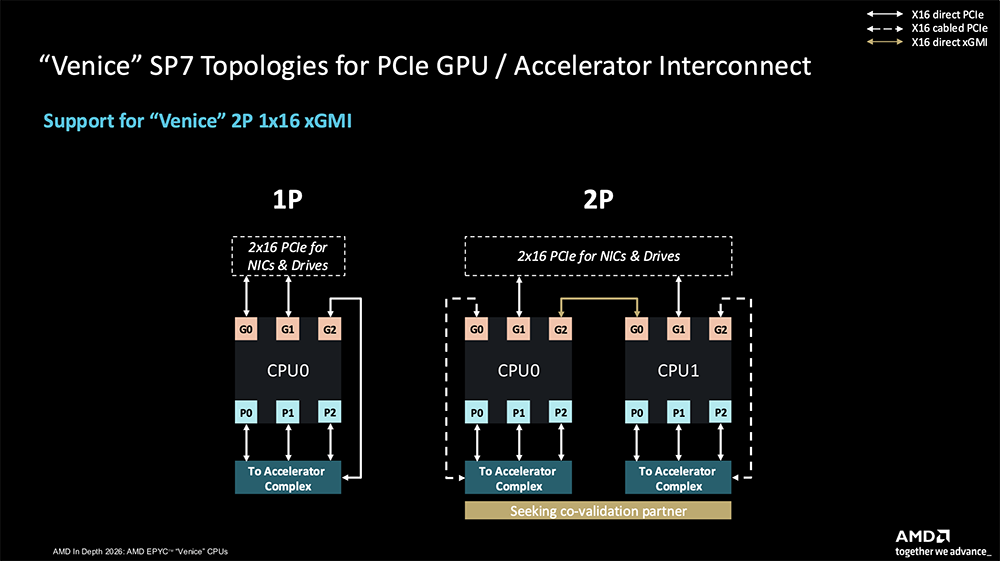
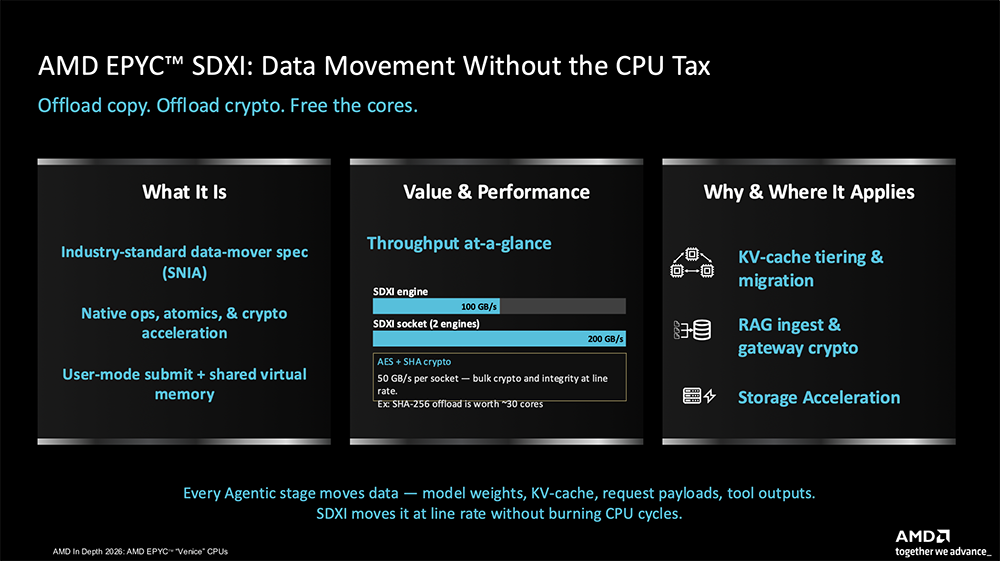
面向不同工作负载,“Venice”升级至 PCIe Gen 6 ,单通道速率升至 64GT/s ,还引入了新的前向纠错机制、信号传输方式及FLIT模式,以提高数据传输效率。 SP7单路最多可配96条PCIe Gen 6和额外8条PCIe Gen 4,双路最多可配128条PCIe Gen 6和额外16条PCIe Gen 4。 “Venice”也优化了数据如何进入CPU的方式,新增 PTM(Precision Time Measurement,精确时间测量) 功能,用于对齐CPU端口和PCIe设备的时间基准;在虚拟化和机密计算方面,支持 PCIe链路IDE(Integrity and Data Encryption,完整性与数据加密) ;继续支持热插拔及高级错误报告(AER)等功能。 此外,PCIe Gen 6引入了更灵活的链路功耗管理能力。 L0p低功耗状态切换 允许链路保持通信能力的同时,进入较低功耗状态,并根据需要恢复更高的传输能力。 直接缓存注入 功能允许设备把即将使用的数据送入缓存,缩短CPU取数据的路径。“Venice”则改进了这项能力的启用方式,设备支持TPH(TLP Processing Hints,事务层数据包处理提示)时可以利用其提示,平台也可为部分不支持TPH的设备提供缓存注入。 同时,客户可根据两个CPU节点之间的NUMA平衡需求,选择使用2或3条xGMI链路。多留几条给xGMI插槽互连,跨插槽数据交换的带宽更高;少用一部分,则可腾出更多资源接外设。 执行内存数据复制、清零和加密等操作,可以交给 SDXI数据搬运引擎 。AMD预计SDXI的数据搬运吞吐量约为 100GB/s ,密码学加速吞吐量约为 50GB/s 。 该引擎还支持虚拟化。客户可将其作为支持SR-IOV的设备进行配置,再将相应功能分配给指定客户虚拟机,虚拟机就能直接利用这些数据搬运和加密加速能力。
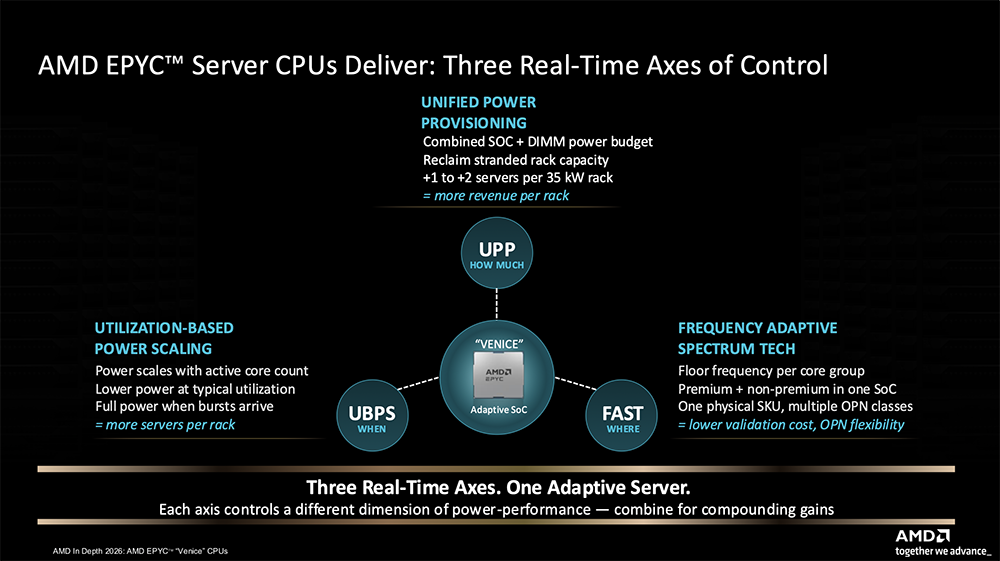
随着CPU核心数量增加,如何降低计算核心之外其他SoC模块的功耗,变得越来越重要。 为此,AMD设计了一种 Fabric功耗状态切换机制DFP State Change ,可根据工作负载动态调整Fabric互连网络的运行频率,例如在延迟敏感时提高频率、在带宽受限时适当降低频率。 AMD称新一代架构已大幅缩短了功耗状态切换时间,在不同阶段切换时可避免产生数据传输中断窗口。 AMD观察到,数据中心运营商希望解决三类功耗管理挑战:一是利用被闲置的功率预算,二是动态调整功耗,三是解决达到功率闲置时的性能管理问题。 对此,3项技术构成了“Venice”的功耗管理方案: (1)UPP,统一功率配置。 把CPU SoC和DIMM视为一个统一的功率预算管理单元,利用两者峰值未必同时出现的特点,减少预留的功率预算,预计特定平台的功率容量规划需求可降约10%~15%。 (2)UBPS,基于利用率的功率伸缩。 根据系统忙闲动态调整功率,负载回升时再为更高电压和频率提供预算,更灵活地平衡性能与功耗。 (3)FAST,频率自适应频谱技术。 给不同CPU核心划分性能优先级,触及功率或温度上限时,优先让低优先级核心降频,尽量保住关键线程的响应时间。 这三项技术可叠加使用。客户可以对整个平台进行性能与功耗特征分析,再决定在什么情况下使用哪些技术,从而在平台层面实现更精细的性能和功耗优化。
任何数据中心技术都离不开对 RAS(可靠性、可用性和可维护性) 的高度重视。 在 扩展RAS功能 方面,“Venice”支持PCIe高级错误报告和CXL 3.1设备故障恢复,内存方面继续支持Chipkill级内存可靠性保护,并增强了机器检查架构的错误记录。 AMD也在与 OCP(开放计算项目) 密切合作,支持其RAS生态系统中的API增强,并正在减少研究如何减少对SMI/SMM(系统管理中断/系统管理模式)的依赖。 从“Venice”中,AMD引入了一项 MPRAS 新功能,它利用片上专用微控制器,把部分原先需要SMI处理的部分工作卸载到片上,从而减少对业务线程的打断。 除了这些改进外,AMD也持续增强各类互连链路的可靠性。例如,链路加密、前向纠错、CRC校验等机制,都是确保数据传输可靠性的重要组成部分。 机密计算 和 安全功能 始终是AMD的关注重点,该公司从底层硬件能力出发,向整个系统软件栈扩展安全保护。 “Venice”继续配备专用安全子系统,提供灵活的机密性保护,引入加入RSA-4096,为PQC(后量子密码学)做好准备,将零信任理念延伸到芯片层,支持Calyptra 1.2硬件信任根,持续保护AI工作负载安全,并为客户提供自主控制平台的功能。 在机密计算方面,Zen 6指令集改进了 SEV-SNP (保护页映射的完整性),提供 RMPOPT、DIRTY bit优化和增强的SMT保护 ,分别用于快速降低非安全虚拟机与机密虚拟机混部时的检查开销、让虚拟机实时迁移变得更加容易、在充分发挥SMT性能的同时提供安全隔离。 “Venice”还支持 SEV-TIO 。它构建于PCIe链路加密能力之上,结合TDISP,让符合条件的设备加入可信执行环境。对于只需保护链路的部署,PCIe IDE可独立启用,提供数据加密和完整性保护。 此外,AMD引入一项 设备来源可验证 能力,将制造阶段的硬件物料信息与芯片身份做密码学绑定,让客户能在芯片层面追溯设备来源,帮助验证设备的真实性和完整性,并通过OCP S.A.F.E.推进安全审计的透明度。
从第六代EPYC服务器CPU的设计思路,可以看到AMD对后续云端计算市场发展趋势的研判:服务器CPU的需求会继续分化,不同类型的客户会按实际工作负载来配置算力基础设施。 AMD用同一代微核心架构和Die设计,做出高频率、高密度、高性能、高内存带宽配置,再通过不同SoC平台来提供不同配比的内存与I/O,不仅能服务云端的高并发,还能覆盖GPU主机、HPC和企业存储等市场需求。 同时,AMD将优化目标从单颗CPU扩大到了整台服务器,通过一系列技术决策,来解决如何在有限内存和供电条件下将更多CPU核心转换成有效算力的问题。 随着内存资源压力日益严峻,MEXT有望成为AMD未来加强数据中心市场竞争力的一个关键引擎。目前MEXT主要与AMD服务器CPU打配合,我们也期待看到未来将这一技术解耦、适配更多类型CPU的可能性。 第六代EPYC服务器CPU既能作为通用服务器CPU独立销售,又能成为智能体AI系统的基础。而AMD可以提供从芯片到机架覆盖面极广的丰富选择。
转载说明:本文系转载内容,版权归原作者及原出处所有。转载目的在于传递更多行业信息,文章观点仅代表原作者本人,与本平台立场无关。若涉及作品版权问题,请原作者或相关权利人及时与本平台联系,我们将在第一时间核实后移除相关内容。
 五度妙笔
 企业透视镜
 API商城

 数据库