
 五度妙笔
 企业透视镜
 API商城

 数据库
Sci Adv:清华大学梁冠翔团队破解宏基因组“酶暗物质”,FEDKEA开启功能注释新范式
宏基因组数据具有显著的生物学潜力,但其功能解释常因不完整的蛋白质功能注释而受阻。准确的酶注释对于阐明宏基因组数据集中微生物群落的代谢能力至关重要。
2026年8月19日,清华大学梁冠翔独立通讯在
Science Advances
在线发表题为
Large language models enhance annotation of enzymes in metagenomes
的研究论文。
该研究开发了FEDKEA——一种利用蛋白质语言模型的酶注释工具,并为其使用提供了一个网络平台。此外,作者设计了一个用户友好的、基于FEDKEA的宏基因组流程MEnzMap,涵盖从原始数据质量控制到功能预测和下游分析的整个分析工作流程。
将MEnzMap应用于来自iHMP2项目的人类肠道宏基因组数据,作者为健康个体和炎症性肠病患者生成了一个全面的酶谱景观。这些工具为微生物暗物质的功能注释提供了一种高效方法,并促进了对疾病相关酶的识别。
微生物组由栖息于人体各区域的高度多样且复杂的微生物群落组成,在健康和疾病中发挥关键作用。高通量测序技术的出现彻底改变了微生物组研究,导致大量宏基因组测序数据的产生。然而,这些宏基因组数据的功能注释仍然是一个重大挑战,因为许多微生物基因和通路仍未被表征或理解甚少,通常被称为微生物暗物质。
人微生物组中产生的微生物酶在消化、生物合成、宿主-微生物相互作用以及各种其他生理过程中发挥关键作用。这些酶对于宿主健康至关重要,并为微生物组相关疾病提供了见解,同时为解决菌群失调展现了治疗潜力。
鉴于微生物组中大量未注释的蛋白质功能,迫切需要新的计算方法来注释微生物的酶功能。已开发了多种基于序列相似性、同源建模、结构分析、机器学习和深度学习的酶功能注释工具,并显示出有前景的结果;然而,在宏基因组分析方面仍有显著的改进空间。
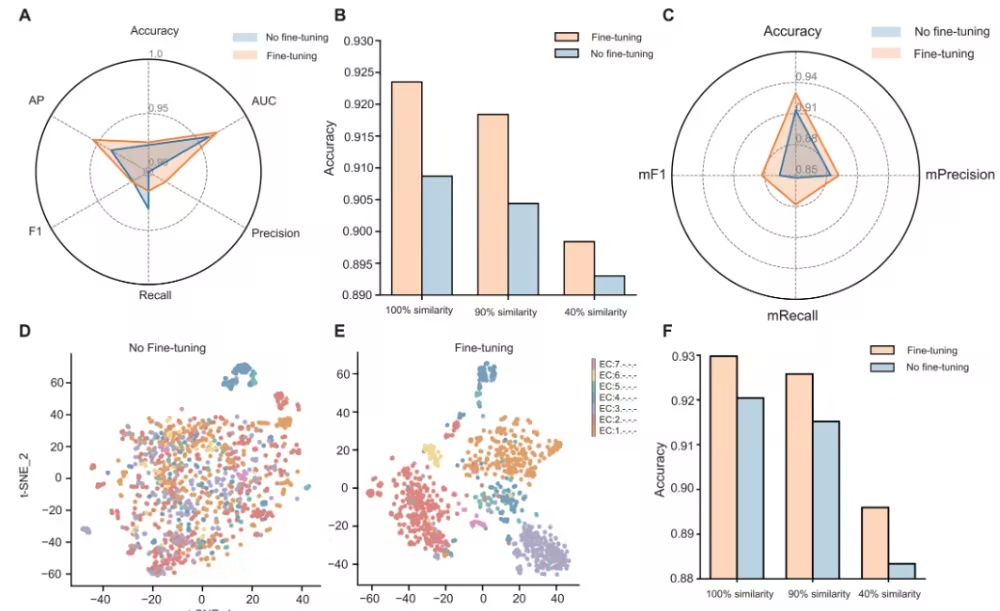
图1.FEDKEA框架的消融研究和微调策略评价(摘自
Science Advances
)
在此,作者使用蛋白质大型语言模型,结合EC(酶学委员会)分类的层级结构,开发了FEDKEA(基于微调的ESM-2和基于距离的KNN进行酶注释)。为进一步与宏基因组应用对接,作者基于FEDKEA开发了一个用户友好的流程,名为MEnzMap(微生物中的宏基因组酶图谱)。
作者进一步重新分析了iHMP2项目的宏基因组数据,以描绘人类微生物组的酶景观,并鉴定出与健康对照相比,炎症性肠病患者中抗氧化相关酶的减少。
参考消息:https://www.science.org/doi/10.1126/sciadv.aee4389


