
 五度妙笔
 企业透视镜
 API商城

 数据库
改写生命“底层语言”,《Nature》突破遗传密码扩展的百年教条:教科书级“铁律”被推翻——没有CCA末端的tRNA,居然也能干活
生命仅用64种密码子编码20种氨基酸,而其潜力远不止于此。过去20年,科学家渴望通过引入非标准氨基酸(nsAAs)扩展这一“语言”,让细胞合成新材料、新药物和新催化剂。
传统密码子扩展技术虽已成功引入400余种nsAAs,但大多局限于单个或少数密码子位点,无法对整个遗传密码进行系统性重塑。其中最大的拦路虎,是一条被视为铁律的教条:tRNA的3‘端必须保留CCA序列,才能被氨酰-tRNA合成酶(aaRS)正确装载氨基酸。
2026年8月26日,哈佛医学院George M. Church团队在
Nature
在线发表题为
Automated prototyping of genetic codes
的研究论文,该研究提出了AGENTEX系统,彻底重写了这一认知边界。
研究团队首先剖析了核糖体大亚基(23S rRNA)中G2251/G2553与tRNA 3’端CCA形成沃森-克里克碱基配对的关键机制。他们以此为切入点,假设通过工程化改造核糖体,或许能接纳携带非CCA末端的tRNA(otRNA)。
反直觉的新发现:aaRS远比想象中“宽容”
传统观点认为,绝大多数大肠杆菌aaRS严格依赖tRNA的3‘端CCA完成氨基酸偶联。但研究团队利用机器人技术和下一代测序开发的多组分定量平台,对完整的大肠杆菌tRNA池进行了系统性扫描,惊异地发现:大量otRNA(携带CUA、CAA等变异末端)在未修饰状态下,仍能被所有大肠杆菌aaRS成功装载,且效率远超此前预期。
这意味着进化保守的“3’-CCA教条”并非绝对钢律,而是翻译系统精准性的一种偏好性选择。
AGENTEX平台:从“手工定制”到“自动化读写”
基于这一发现,AGENTEX系统实现了遗传密码的快速原型化。通过将携带工程化反密码子的otRNA池,与改造后仅识别非CCA末端的突变核糖体(G2251C/G2553C)结合,研究者构建了真正意义的双重正交翻译系统:既保持天然tRNA-核糖体配对,又能让otRNA特异性地行使新功能。
利用该系统,团队成功构建并测试了将遗传密码压缩至34个密码子对应34种aaRS的最小密码,并评估了包含非标准氨基酸掺入、最多三个密码子重新分配的定制密码子组合。
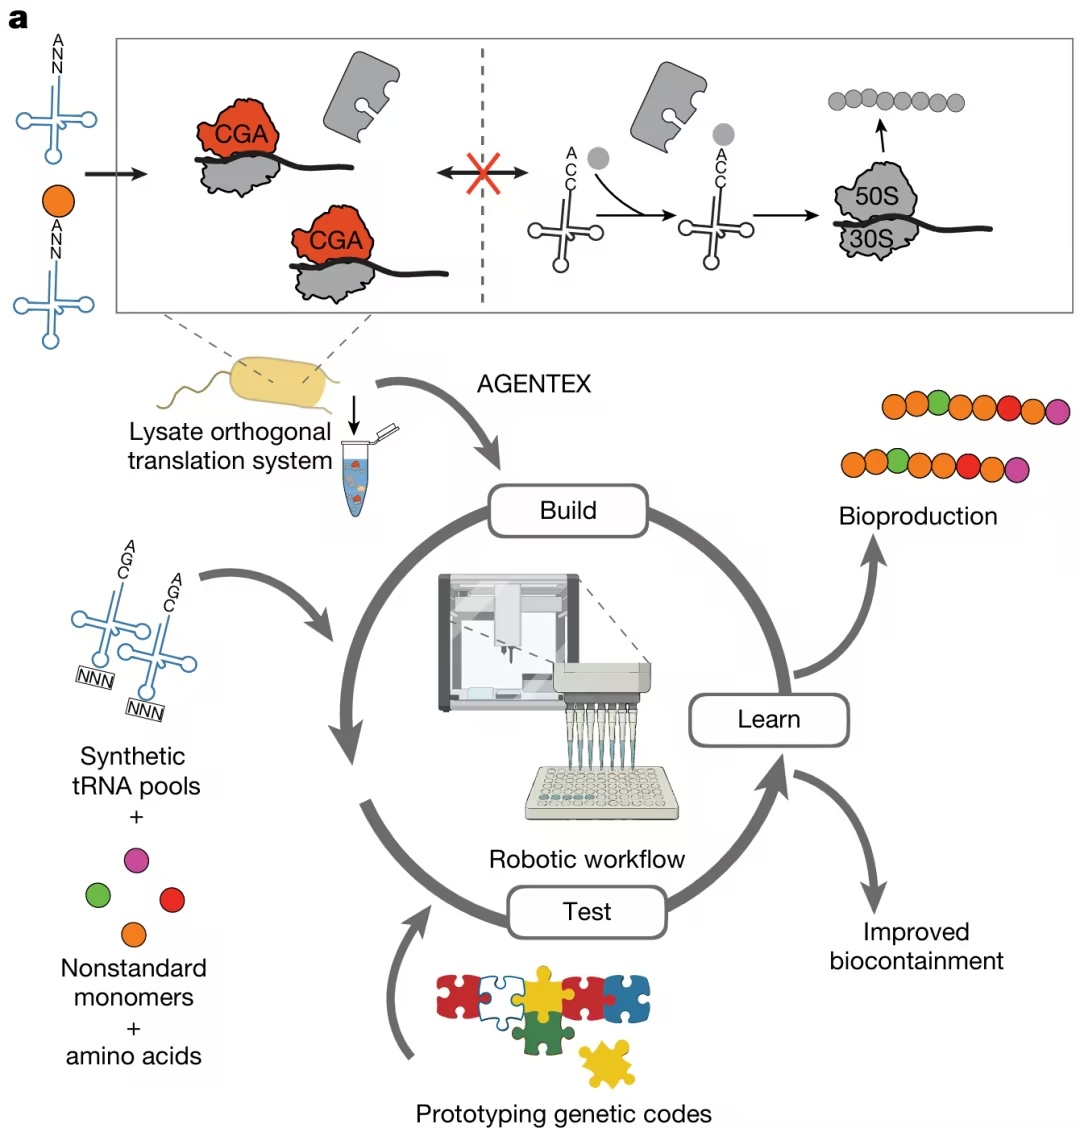
AGENTEX 可实现基因序列的并行检测以及基于序列的生物聚合物合成(图源自
Nature
)
改写翻译系统的“进化隐喻”
该研究不仅为合成生物学提供了一台高效“基因语言编译机”,更对进化生物学提出了深层叩问:如果我们能轻松突破CCA限制,为何自然选择始终保留这一末端的普适性?答案或许在于,这种“冗余”本身正是翻译精准性和鲁棒性的保障——正是这一“保守”给我们留下了重新布局遗传空间的巨大设计自由度。
客观评价与开放边界
需指出的是,AGENTEX目前局限于无细胞裂解物体系,体内基因组重编码的核心挑战(如脱靶编辑、细胞毒性、氨酰化效率)尚未完全解决。本研究主要展示了概念验证与体外聚合物的合成,其模块化设计是否能够以足够的保真度和通量宏量生产复杂聚合物,仍有待工程优化。
此外,人工压缩遗传密码后细胞的代谢适配性问题、以及专利和生物安全问题也是未来转化中不可回避的课题。但AGENTEX无疑打破了“遗传密码不可触碰”的思维桎梏,为最终实现对序列定义化学的完全控制铺平了道路,也让我们得以一窥“翻译系统”在进化长河中未被揭晓的柔软身段。
参考消息:https://www.nature.com/articles/s41586-026-10949-y


