五度妙笔
 企业透视镜
 API商城

 数据库
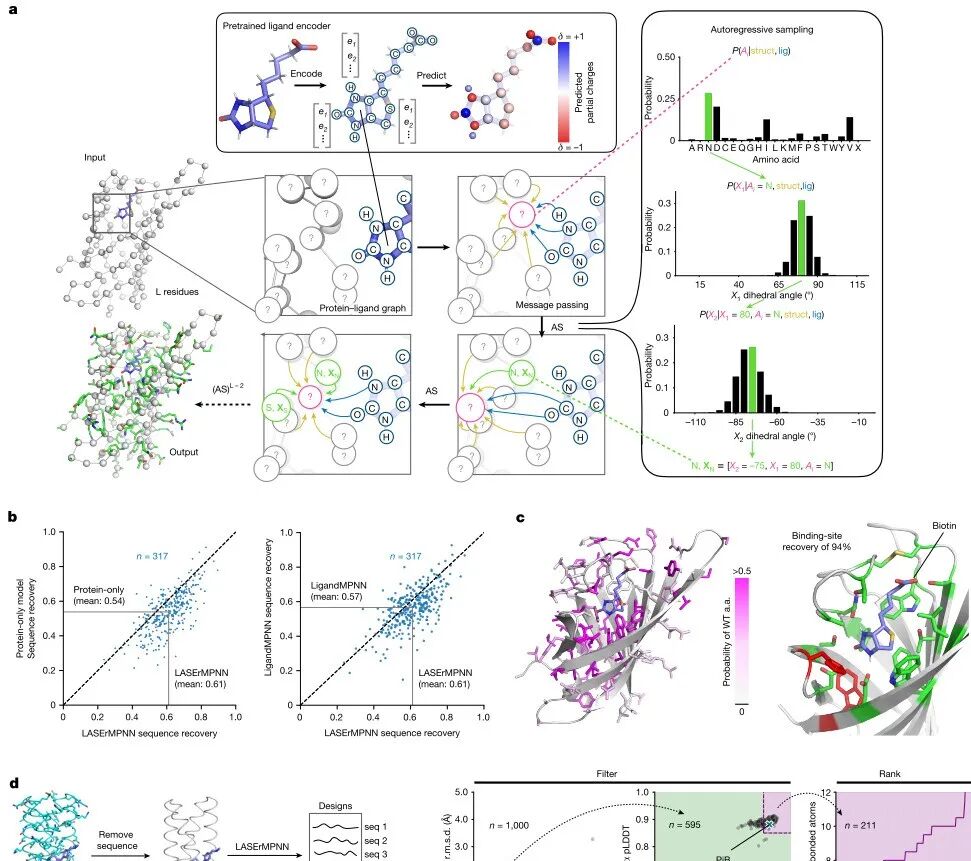
祝贺!我国院士团队再发Nature,攻克药学领域世纪难题,成功入选年度十大学术进展!

八大热门专题


特惠福利:
(报名一门直播课赠送两门回放)
(报名三门直播课赠送以下全部)
01.单细胞测序与空间转录组学
02.深度学习解析宏基因组学
03.机器学表观组与转录组
04.深度学习质谱蛋白组学
05.机器学习生物医学
06.AI智慧医疗影像
07.医疗AI多模态大模型
08、深度学习在基因组学中的应用
09、CRISPR-Cas9基因编辑技术
10、AI抗菌肽设计
11、CADD(进阶班)
12、机器学习微生物组学
13、合成生物学与基因电路设计
14、蛋白晶体结构解析
(向上滑动查看内容)
学习目标: 理解现代蛋白质设计的理论基石,建立从“功能”到“结构”再到“序列”的正确设计观。
蛋白质折叠问题与经典设计:
。回顾“CASP历史”以及蛋白质折叠问题的复杂性 。
。介绍David Baker实验室与IPD的设计哲学:以最终功能为导向,设计自然界不存在的全新蛋白质结构。
。讲解Rosetta软件的核心思想,理解其作为蛋白质设计基石的历史地位与方法论
模块二:核心AI模型原理与代码实现
学习目标:从原理和代码层面,彻底理解驱动现代蛋白质预测与设计的两大核心神经网络架构。
·基础工具与环境:
o掌握Numpy进行多维数组(Tensor)操作 。
o学习PyTorch的核心概念:张量、自动求导机制
o讲解服务器GPU与CUDA的基本工作原理,为后续的本地化部署打下基础。
·关键模型架构拆解:
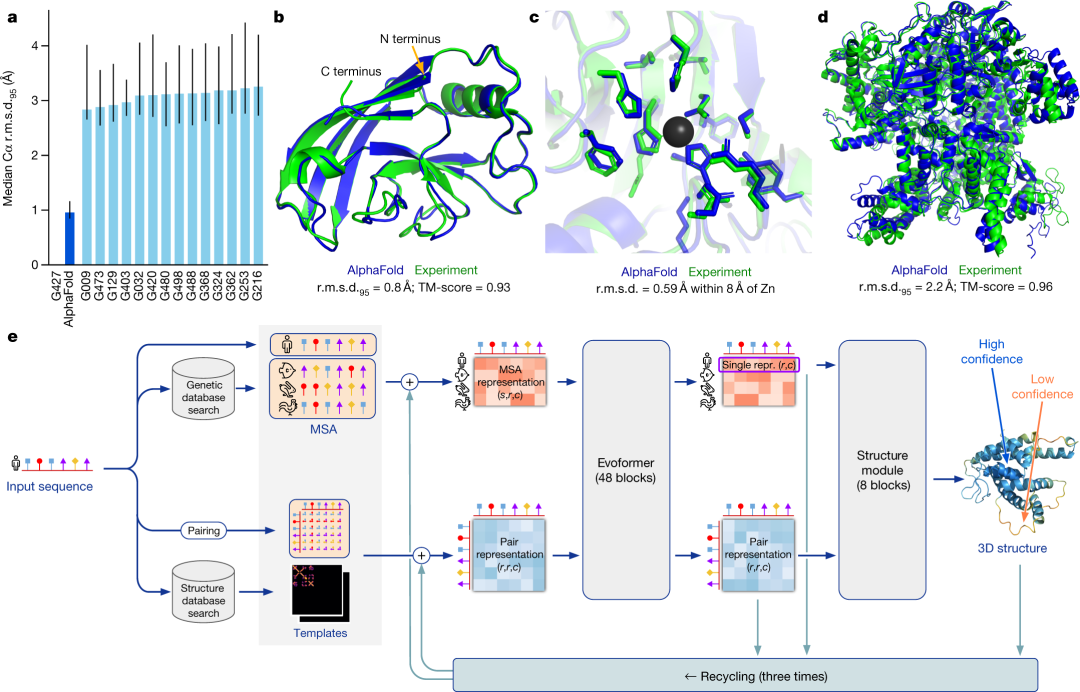
oTransformer与Attention机制:深入讲解Transformer模型如何通过自注意力机制捕捉序列中的长距离依赖关系,并分析其如何被AlphaFold 2用于整合多序列比对(MSA)信息和空间几何信息,构成Evoformer模块的核心 。
o扩散模型 (Diffusion Model):详细阐述扩散模型的前向加噪(Forward Process)与反向去噪(Reverse Process)的数学原理 。重点讲解该模型如何被应用于RFdiffusion,实现从高斯噪声中逐步生成结构合理的蛋白质骨架
代码实践:所有模型原理都将配合Jupyter Notebook进行代码实操,确保学员不仅理解理论,更能动手实现。
模块三:前沿设计工具链:原理、部署与应用
学习目标:掌握当前最高效的蛋白质设计“三要素”工具链,并完成本地化部署,具备独立开展计算设计的能力。
A. 结构生成 (RFdiffusion):
功能详解:学习RFdiffusion如何从随机噪声中生成全新的蛋白质骨架 。
实操技术:重点讲解几种核心设计模式的应用场景与参数设置:
无条件生成 (Unconditional generation):用于创造全新的拓扑结构。
基于骨架的生成 (Scaffolding):在已有的结构骨架上进行延申或构建。
功能位点限定生成 (Inpainting):在固定关键功能位点(如活性中心、结合界面)的前提下,生成包裹该位点的全新结构。
B. 序列设计 (ProteinMPNN):o核心问题:讲解“蛋白质反向折叠 (Inverse Folding)”问题的挑战性,即如何为给定的骨架设计出能正确折叠的氨基酸序列 。o协同工作流:演示如何将RFdiffusion生成的骨架(Backbone)作为输入,利用ProteinMPNN设计出高稳定性的氨基酸序列,形成完整的“结构-序列”设计流程 。
C. 结构验证与功能拓展 (AlphaFold 3):
o精度验证:学习使用AlphaFold 2/3验证由ProteinMPNN设计的序列,能否高精度地折叠回RFdiffusion所设计的初始结构 。重点讲解pLDDT和PAE图的解读,用于评估预测结果的置信度 。
o功能预测:介绍AlphaFold 3的核心突破——其预测能力已从单一蛋白质扩展到蛋白质、DNA、RNA、配体等多种分子的复合物 。探讨如何利用这一特性,初步评估设计的蛋白质与靶点分子的相互作用,为药物设计提供关键信息。
模块四:应用方向专题实战
学习目标:将前面学习的工具链应用到三个主流的生物医药研发场景中,解决具体问题。
总学习目标:通过三个独立的、项目驱动的专题,让学员完整地、端到端地执行计算蛋白质设计的流程。在课程结束时,学员不仅掌握了工具的使用,更能理解在不同应用场景下(酶、抗体、从头设计)的设计策略、关键考量和技术组合。
专题一:从头设计功能性Binder
技术流程:一个完整的综合性项目。学员将选择一个具体靶点,独立运用“RFdiffusion → ProteinMPNN → AlphaFold”的全套技术流程,从零开始设计一个能够特异性结合该靶点的全新小分子蛋白(Binder),完成一个标准化的de novo设计流程。
项目目标:执行一个完整的、工业界标准的de novo设计流程,针对一个选定的蛋白靶点,从零开始设计一个能够特异性结合其表面的全新小分子蛋白(Binder)。
核心概念:De novo设计、蛋白质-蛋白质相互作用(PPI)、形状互补性、计算流程的端到端整合。
技术流程详解:
1.靶点分析与结合位点选择:
o选择一个感兴趣的靶点蛋白(如疾病相关蛋白)。
o分析其表面性质,选择一个适合作为结合靶点的区域(通常是相对平坦、具有一定疏水性的表面)。
2.基于靶点的骨架生成 (RFdiffusion):
o此为设计的核心创造步骤。学员将学习使用RFdiffusion的功能位点限定生成 (Inpainting)模式。
o将靶点蛋白的结构作为固定的“环境”,RFdiffusion会在此环境的约束下,从噪声中“生长”出一个与靶点表面形状高度互补的全新蛋白质骨架。
3.序列填充与优化 (ProteinMPNN):
o将上一步生成的最优骨架输入ProteinMPNN。
oProteinMPNN会为这个全新的骨架设计出能够稳定折叠的氨基酸序列,完成从“形状”到“化学本质”的转化 。
4.双重计算验证 (AlphaFold):
o步骤一:单体验证。将ProteinMPNN设计的序列输入AlphaFold,预测其单体结构。验证该序列能否独立折叠成我们设计的形状(高pLDDT得分,且RMSD与设计模型低)。
o步骤二:复合物验证。使用AlphaFold-Multimer 预测设计的Binder和靶点蛋白的复合物。验证Binder能否如预期般结合到靶点的正确位置(低界面PAE得分)。
项目目标:针对一个给定的酶,通过计算方法,设计出具有更高热稳定性或催化活性的突变体,并提供一套可供实验验证的候选序列。
核心概念:适应性景观 (Fitness Landscape) ,定向进化 ,酶催化与过渡态理论 (Transition State Theory) ,计算诱变 (In-silico Mutagenesis),折叠自由能 (ΔG)。
技术流程详解:
1.模板选择与结构准备:
o从蛋白质结构数据库(PDB)中选取一个具有已知结构和功能的酶作为改造模板。
o若无实验结构,将学习利用UniProt 寻找同源序列,并使用SWISS-MODEL 或本地AlphaFold进行结构预测,获得可靠的起始模型。
o使用PyMOL 或ChimeraX 分析酶的活性位点、底物结合口袋以及潜在的不稳定区域(如高柔性loop)。
2.计算突变扫描与稳定性预测:
o学习使用Rosetta等工具包中的能量函数,对酶的特定区域(或全长)进行计算饱和突变扫描。
o核心技术点是计算每个突变体相对于野生型的折叠自由能变化 (ΔG)。学员将学习如何解读ΔG值,以筛选出能够提升蛋白质热稳定性的有益突变。
3.催化性能的计算评估:
o对于活性位点附近的突变,将引入分子对接(Molecular Docking)方法,模拟底物或过渡态类似物与突变酶的结合情况。
o通过比较结合能、关键相互作用(氢键、盐桥等)的变化,来半定量地预测突变对催化活性(kcat/KM)的潜在影响。
4.候选突变体的筛选与组合:
o基于上述计算结果,学员将学习如何制定筛选策略,例如,优先选择同时提升稳定性且不损害(或提升)活性的突变。
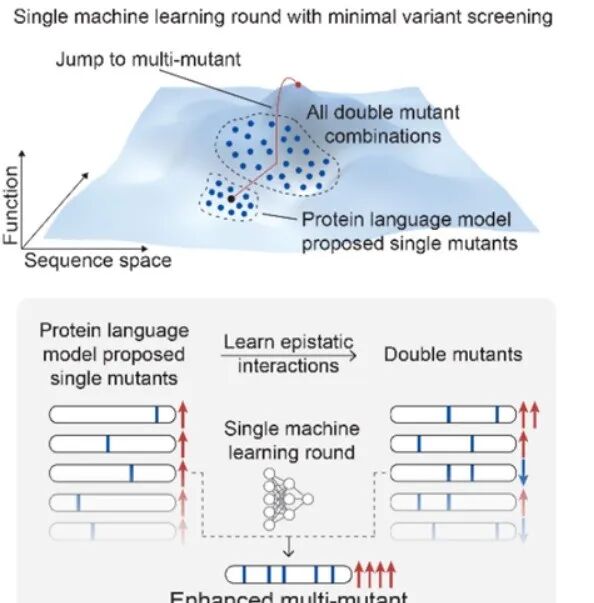
o探讨如何组合多个有益的单点突变,以获得性能提升更显著的多点突变体。
项目目标:掌握计算辅助的抗体亲和力成熟(Affinity Maturation)流程,针对一个已知的抗体-抗原复合物,设计新的互补决定区(CDR)序列,以增强其结合能力。
核心概念:抗体结构域、CDR与框架区(FR)、抗原表位(Epitope)与互补位(Paratope)、抗体人源化、亲和力与特异性。
技术流程详解:
1.抗体-抗原复合物的结构分析:
o从PDB中选取一个抗体-抗原复合物结构作为起始点。
o利用可视化软件,精确识别构成结合界面的CDR loop,特别是贡献最大的CDR-H3。
o详细分析界面上的氢键、疏水作用、盐桥等关键相互作用,理解亲和力的结构基础。
2.CDR区域的序列设计:
o固定抗体的框架区和抗原结构,仅针对CDR区域进行序列设计。
o学员将使用ProteinMPNN等工具,在保持CDR loop骨架构象的同时,重新设计其氨基酸序列,以期发现能与抗原形成更优相互作用的新序列。
3.利用AlphaFold-Multimer进行复合物结构预测与评估:
o将新设计的CDR序列整合回抗体,形成一个完整的突变抗体序列。
o使用AlphaFold-Multimer 预测新设计的抗体与抗原的复合物结构。这是流程中最关键的一步。
o学员将学习如何解读AlphaFold-Multimer的输出结果,特别是利用PAE(Predicted Aligned Error)图来评估界面预测的置信度,判断新设计的抗体是否仍能以正确的模式结合抗原。
4.亲和力排序与候选筛选:
o通过比较不同设计方案的界面结合面积、预测的氢键网络、以及界面PAE得分等指标,对设计的抗体进行排序。
o筛选出1-3个预测结合能力最强、且结构最可靠的候选抗体序列。
(向上滑动查看内容)
(向上滑动查看内容)
第一天
启程·洞见药物设计的微观世界 (Vision & Foundation)
上午:理论基石——计算药物设计的思想与方法
·模块一:药物发现的源头——为何蛋白质三维结构至关重要?
o经典方法:同源建模(Homology Modeling)的逻辑与应用
o前沿探索:从头建模(de novo Modeling)的挑战与突破
·模块二:锁定靶心——蛋白质活性位点的识别与意义
o探索药物与靶点的“钥匙-锁”关系
·模块三:分子之舞——优秀药物分子的关键结构特征
o解构小分子药物的构效关系奥秘
·模块四:CADD核心武器库概览
o分子对接(Molecular Docking):预测分子间的“亲密接触”
o虚拟筛选(Virtual Screening):在百万分子中“大海捞针”
o分子动力学模拟(Molecular Dynamics):观测分子的动态行为
o其他前沿计算方法简介
下午:实战预备——可视化工具与数据解读
·模块五:解锁生命蓝图——蛋白质结构数据库(PDB)深度解析
o高效检索:精准定位你的目标蛋白
o信息解读:全面掌握PDB页面信息与生物学含义
o数据获取:标准数据的下载与管理
o破译密码:PDB文件格式的结构化解读
·模块六:PyMOL大师课——从入门到精通的分子可视化
o初识PyMOL:核心功能与界面导览
o基础操作:旋转、缩放、选择与着色
o高级渲染:绘制精美的蛋白/小分子表面图与静电势分布图
o成果展示:精准绘制相互作用图并制作引人注目的科学动画
第二天:构建·从序列到三维结构的创生 (From Sequence to Structure)
上午:同源建模专题——预测未知的蛋白质结构
·模块一:同源建模的原理与应用场景
o何时以及为何选择同源建模?
o揭秘同源建模背后的核心算法
·模块二:Swiss-Model实战工坊
o第一步:通过BLAST等工具寻找最佳同源模板
o第二步:序列比对的艺术与技巧
o第三步:精准选择决定模型质量的蛋白模板
o第四步:自动化与手动搭建蛋白三维模型
o第五步:模型质量的生命线——拉曼图(Ramachandran Plot)分析与解读
o第六步:模型的迭代优化与精修
·案例演练: 以新冠病毒Spike蛋白序列为例,从零开始构建高质量三维结构模型,并进行全流程质量评估。
下午:小分子设计与数据库探索
·模块三:ChemDraw化学绘图实战
o从零开始,构建任意复杂的小分子结构
o一键计算:快速获取分子量、clogP等关键理化性质
o挑战练习:灵活构建大环分子、氨基酸、DNA/RNA片段等特殊结构
·模块四:探索海量的小分子化合物库
o主流数据库巡礼:DrugBank, ZINC, ChEMBL的特色与高效使用技巧
o特色资源探索:天然产物与中药成分数据库的挖掘与应用
第三天:对接·分子间的识别与结合 (The Docking Dance)
上午:分子对接的理论核心
·模块一:解密分子对接的黑箱
o核心原理:计算机如何模拟分子的结合过程?
o对接类型:刚性、半柔性与柔性对接的分类与选择
o评价标准:深入理解不同打分函数(Scoring Function)的物理意义
·模块二:常规分子对接流程实战
o配体准备: 药物小分子的能量最小化与构象优化
o受体准备: 蛋白靶点的预处理(加氢、去水、修复残基)
o定义靶点: 受体结合口袋(Grid Box)的精确计算
o执行对接: 运行高效的半柔性对接任务
下午:对接结果的深度分析与验证
·模块三:结果评估的多维视角
o黄金标准:与晶体结构(co-crystal structure)构象进行对比验证
o能量视角:从结合能与打分函数值评价结合强度
o聚类分析:洞察配体在口袋中的优势结合模式
o决策时刻:如何科学选择最优的结合构象?
·模块四:探索不同的对接策略与软件实现
第四天:进阶·柔性对接与虚拟筛选 (Advanced Docking & Screening)
上午:柔性对接——更真实的分子识别模拟
·模块一:柔性对接的核心流程
o配体的精细化准备与构象生成
o受体准备的特殊考量
o关键一步:定义需要柔性处理的氨基酸残基
o重新定义格点:适应受体柔性的计算盒子
o执行计算并进行结果分析与评估
·模块二:策略选择——半柔性 vs. 柔性对接
o深入比较两种方法的优缺点与适用场景
·模块三:柔性对接的替代实现方案
下午:高通量虚拟筛选——从海量分子中发现先导化合物
·模块四:药物发现的加速器
o小分子文件的“语言”:SDF, MOL2等格式的理解
o瑞士军刀OpenBabel:精通小分子格式的批量转化与处理
·模块五:基于对接的虚拟筛选实战
o流程构建:设计一套完整、高效的虚拟筛选工作
o准备阶段:靶点蛋白的选择与百万级化合物库的获取
o执行阶段:自动化运行高通量对接任务
o结果分析:如何从海量结果中筛选出高潜力的“Hits”分子(Hit Identification)?
第五天:拓展·探索非经典分子相互作用 (Expanding the Horizon)
上午:特殊分子体系的对接挑战
·模块一:小分子-小分子对接
o超越蛋白靶点:探索小分子间的相互作用(例如:药物-糖类)
o独特的结构预处理与对接策略
o案例分析:以糖-小分子对接为例,解读结果并展示
·模块二:蛋白-核酸对接
o探索基因调控与药物干预的奥秘
·模块三:蛋白-蛋白对接(PPI)
otackling a new frontier in drug discovery
下午:QM/MM计算——融合量子化学与经典力学
·模块四:量子化学(QM)基础入门
o理论核心:薛定谔方程的启示
o方法概览:从半经验、HF到后HF方法
o中流砥柱:密度泛函理论(DFT)简介
·模块五:Gaussian计算入门示例
o从分子构建到单点能计算
o结构优化与振动分析
o探索化学反应:过渡态搜索与势能面扫描
·模块六:QM/MM在生物体系中的应用实例分析
o看QM/MM如何精确模拟酶催化反应等复杂过程
第六、七天:升华·分子动力学模拟与自由能计算 (Dynamics & Energetics)
第六天:驾驭Linux与GROMACS——开启MD模拟之旅
·上午:Linux系统基础
o迈入高性能计算的门槛:Linux系统简介
o效率倍增:常用核心命令实操
o软件安装:以GROMACS为例,掌握Linux环境下的程序部署
·下午:MD实战一:溶剂化环境中蛋白质的动态行为
o目标: 全面掌握并亲手操作分子动力学模拟的完整标准流程(力场选择、构建体系、能量最小化、平衡、生产模拟)。
第七天:MD高级应用——配体结合与能量计算
·上午:MD实战二:蛋白质-配体复合物的动力学模拟
o挑战: 学习处理非标准残基(如药物分子)的力场参数化与拓扑文件生成。
·下午:从模拟到定量——MD轨迹分析与自由能计算
o分析模块: 掌握RMSD, RMSF, Radius of Gyration等常用分析方法
o定量模块: 初步接触蛋白-配体结合自由能的计算方法(如MMPBSA/GBSA),定量评估结合强度
(向上滑动查看内容)
第一天|AIDD 概述与药物数据库 & Python 环境工具(6h|理论 3h + 实操 3h)
理论部分(3h)
1.AIDD 人工智能辅助药物设计概述(0.75h)
·传统药物研发痛点,AIDD 发展背景,小分子药物、抗体 / Nanobody 生物药 AI 研发场景,AI 在药物研发全流程介入位点
·AIDD 技术栈总览:传统机器学习、GNN、NLP 生成模型;课程框架:小分子 + 生物药双主线介绍
2.Python 环境搭建与包管理(0.75h)
·Anaconda、VSCode、虚拟环境、pip/conda 镜像源配置;AIDD 生态库介绍
3.科学计算库基础(1h)
·numpy、pandas 分子数据清洗,matplotlib 绘图,requests 网络爬虫
4.药物公开数据库体系(0.5h)
·ChEMBL、PubChem、KEGG、ChEBI、BiGG;DeepChem & MoleculeNet 数据集;抗体 / Nanobody 相关数据库简单引入(SAbDab 等)
1.AIDD 虚拟环境搭建,库安装调试
2.多数据库批量获取小分子数据:KEGG、ChEBI、PubChem、ChEMBL、BiGG 接口调用
3.DeepChem 安装、MoleculeNet 数据集下载与预处理
4.小作业:批量下载靶点活性分子,输出 csv 数据集
第二天|传统机器学习辅助药物设计(6h|理论 3h + 实操 3h)
理论部分(3h)
1.机器学习基础理论(1h)
·监督 / 无监督 / 强化学习;决策树、SVM、朴素贝叶斯、CNN;药物任务:分类(毒性 ADMET)、回归(活性预测)
2.模型评价指标(0.75h)
·分类:准确率、精确率、召回率、F1、ROCAUC;回归:MAE、MSE、R²;交叉验证;药物数据集过拟合、数据偏差问题
3.分子表征与化学信息学(1.25h)
·SMILES、分子指纹、分子描述符、化合物相似性;RDKit 原理;分子构象、RMSD、子结构匹配
实操上机(3h)
1.scikitlearn 完整模型训练、评估、交叉验证流程
2.RDKit 实操:分子读写、绘图、描述符 / 指纹计算、相似度、子结构检索、构象生成与 RMSD
3.项目实战
·实战 1:Lipinski Ro5、ADMET 规则分子筛选
·实战 2:Tanimoto 相似度配体筛选
·实战 3:分子指纹化合物聚类
·实战 4:机器学习生物活性预测
·实战 5:分子毒性预测模型构建
第三天|图神经网络 GNN 辅助药物设计(6h|理论 3h + 实操 3h)
理论部分(3h)
1.图神经网络基础(1.5h)
·图数据表达:小分子、蛋白复合物;节点 / 边 / 图级预测任务;PyG/DGL/TorchDrug 框架;消息传递,GCN/GAT/GIN 原理
·SMILES 转分子图、蛋白配体复合物图构建逻辑
2.GNN 药物领域任务(1.5h)
·小分子毒性、属性预测;蛋白配体相互作用预测;拓展:GNN 在抗体、Nanobody 结构预测、CDR 区建模的应用思路;数据集不平衡问题
实操上机(3h)
1.PyTorch+PyG 环境调试,图数据集基础操作
2.实战 1:DeepChem 图卷积实现分子特征提取与属性预测
3.实战 2:PyG 构建分子图数据集,GNN 分子毒性预测
4.实战 3:蛋白配体相互作用预测
·蛋白配体复合物构建 PyG 图数据集;GIN 模型搭建与相互作用预测
第四天|NLP 大模型辅助药物化学(6h|理论 3h + 实操 3h)
理论部分(3h)
1.药物领域 NLP 基础(1.5h)
·序列向量表示,RNN、Seq2Seq、EncoderDecoder、Attention、Transformer;SMILES 分子语言、化学反应文本表示
2.深度生成模型(1.5h)
·VAE/GAN/RNN/Transformer 分子生成;化学反应预测;分子 BERT 预训练;抗体序列生成、Nanobody CDR 序列设计的 NLP 模型思路
实操上机(3h)
1.PyTorch 与 Transformer 模块调试
2.实战 1:Seq2Seq 无监督分子表示学习
3.实战 2:Transformer 化学反应表示
4.实战 3:NLP 化学反应分类
5.实战 4:BERT 实现化学反应产率预测
第五天|综合项目实战:分子生成 + PyMOL 结构可视化 + 抗体 / Nanobody AI 设计(6h|理论 3h + 实操 3h)
理论部分(3h)
1.RDKit 化学反应计算化学信息(0.5h)
·SMARTS 语法、反应指纹、反应相似度、AI 分子生成原理
2.蛋白数据库与结构可视化基础(0.75h)
·PDB、UniProt、SAbDab(抗体数据库)介绍;蛋白序列、三维结构数据;
·PyMOL 原理:蛋白结构渲染、残基选择、结合口袋显示、复合物作图、抗体 CDR 区可视化基础理论
3.抗体与 Nanobody AI 药物设计专题(1h)
·抗体、Nanobody 结构基础:重链、轻链、CDR 互补决定区;纳米抗体单域蛋白特点
·AI 在抗体药物的任务:序列生成、CDR 设计、亲和力优化、人源化、结构预测、抗原抗体相互作用预测
·主流模型:GNN、Transformer、蛋白大模型在抗体 / Nanobody 的应用;公开数据集 SAbDab、OAS
4.AIDD 完整项目工程流程(0.75h)
·数据集构建预处理表征训练评估落地;数据集偏差、模型踩坑;小分子 + 抗体药物不同落地思路对比
实操上机(3h)
1.RDKit 化学反应实操:反应解析、绘制、SMARTS 定义反应、产物生成、反应指纹与相似度
2.PyMOL 实操教学(1h)
1.PDB 结构导入、蛋白链、残基选择操作
2.蛋白配体复合物可视化:结合口袋、小分子配体渲染、氢键 / 疏水相互作用展示
3.抗体 / Nanobody 结构可视化:定位 CDR 区,抗原抗体复合物作图,导出科研级图片
4.Python 脚本调用 PyMOL(pymolapi)批量处理蛋白结构
3.抗体 & Nanobody AI 设计实战(1h)
1.SAbDab/OAS 数据库下载抗体 / Nanobody 序列与结构数据,数据清洗
2.基于序列大模型做 Nanobody CDR 序列生成、突变设计
3.抗原Nanobody 相互作用简单预测实操
(向上滑动查看内容)
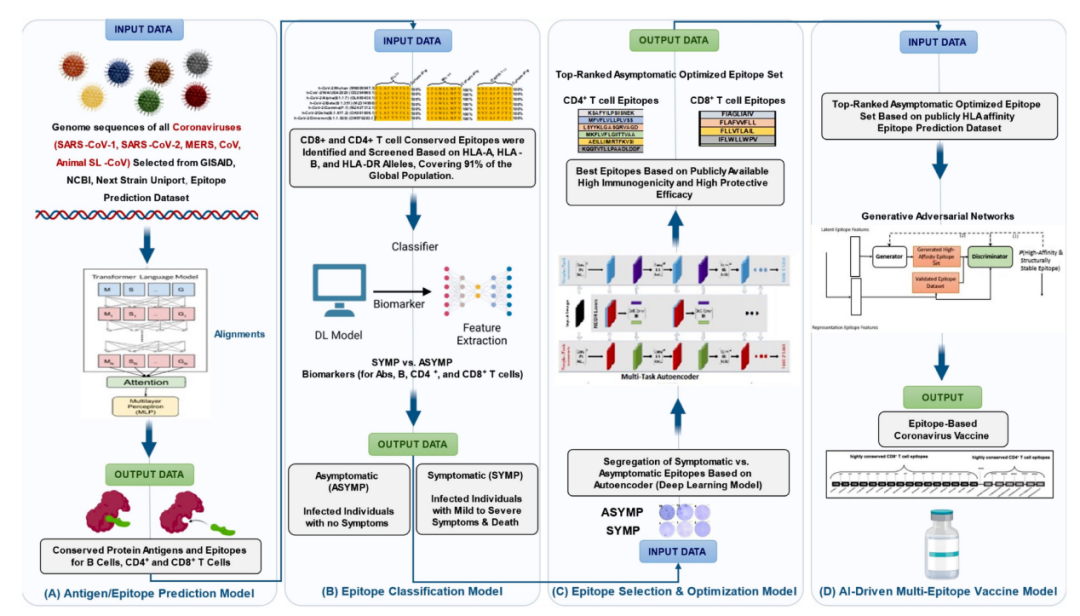
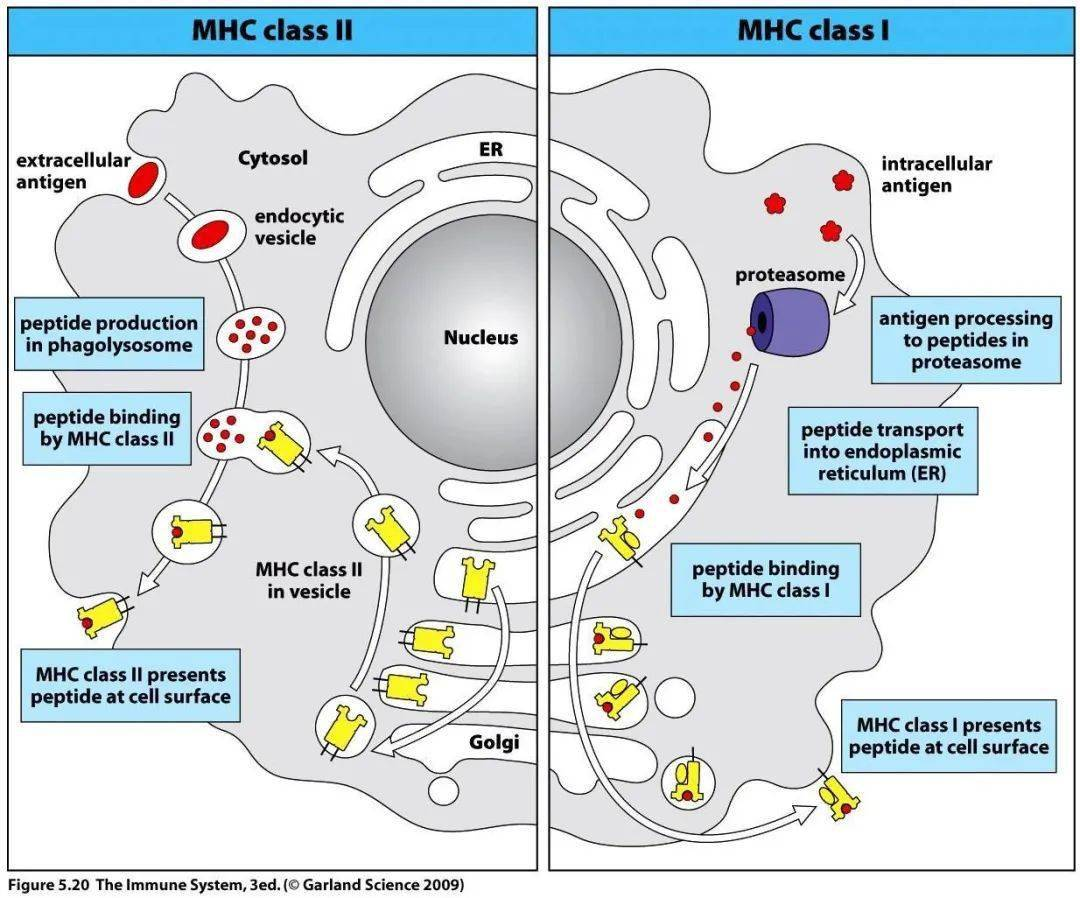
(向上滑动查看内容)
(向上滑动查看内容)
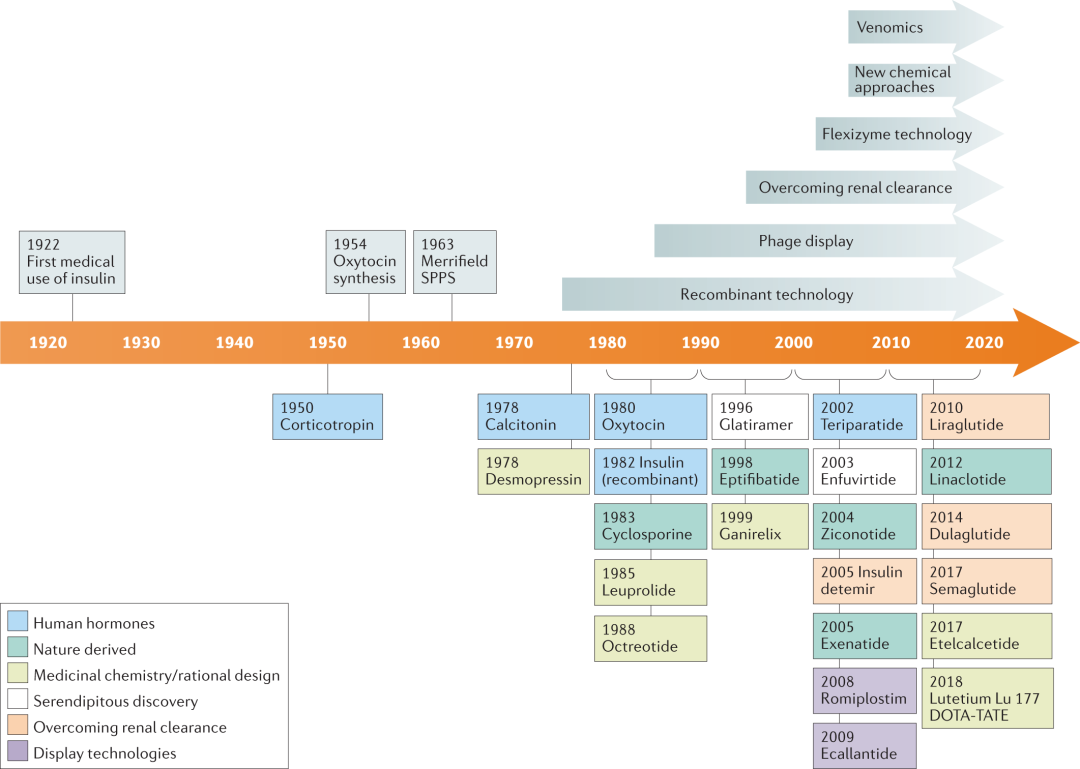
一、多肽与深度学习设计导论
(向上滑动查看内容)


.人工智能构建虚拟细胞
AI蛋白质设计
AI多肽设计
CADD计算机辅助药物设计
AIDD人工智能药物发现与设计
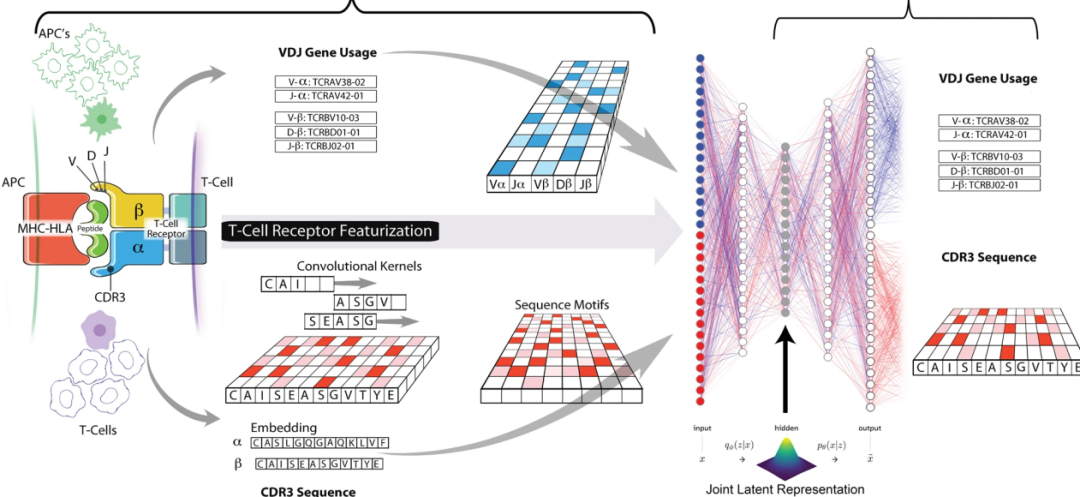
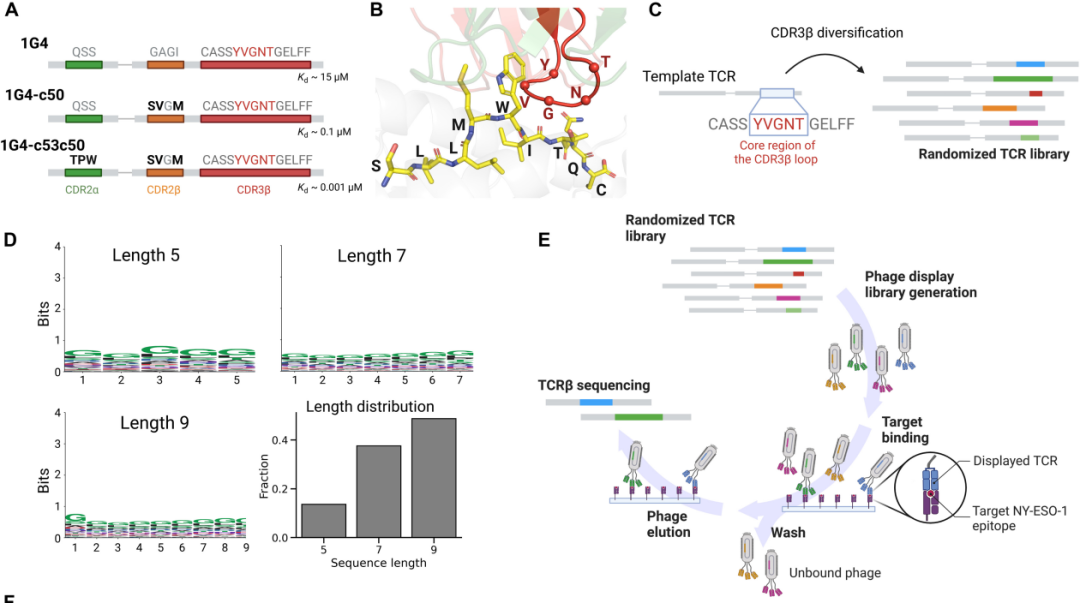
AI计算免疫学
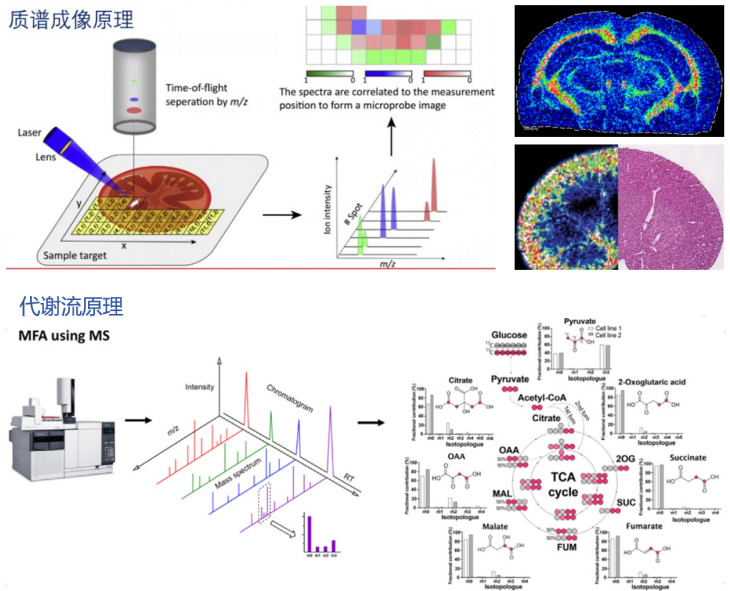
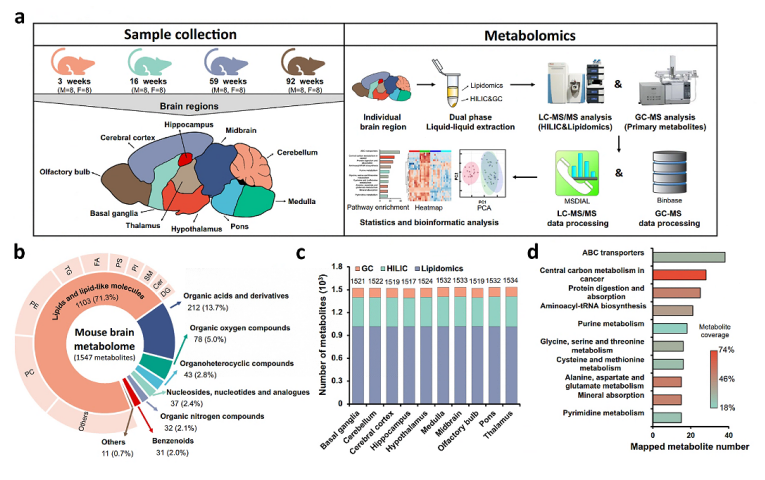
机器学习代谢组学
AI抗体设计

报名费用及福利
AI蛋白质设计、
公费价:6380元 自费价:5880元
人工智能构建虚拟细胞、
AI多肽设计、
CADD计算机辅助药物设计、
AIDD人工智能药物发现、
AI抗体设计、
机器学习代谢组学、
AI计算免疫学、
每人每班公费价:5880元
每人每班自费价:5480元
优惠福利如下:
优惠一:报二赠一:10880(可选三门课程)
优惠二:报三赠一:13880(可选四门课程)
优惠三:报四赠二:18880(可选六门课程)
优惠四:全报25880(两年内可参加本公司举办的任何课程,不限次数及课程,包括之后新课)
限时福利:报名成功后转发朋友圈或转发50人以上群聊即可获得300元现金红包(只限前15名)
课程福利:报名缴费后可获取往期课程回放(包含全套课程回放和课件资料ppt)提供学员课前预习
报名费用可开具正规报销发票及提供相关缴费证明、邀请函,可提前开具报销发票、文件用于报销 。报名缴费后即可获得全套预习资料供大家课前准备
证书:参加培训并通过考试的学员,可以申请获得工业和信息化部工业文化发展中心颁发的“工业强国建设素质素养提升尚工行动”岗位能力适应评测证书。该证书可在中心官网查询,可作为能力评价,考核和任职的重要依据。评测证书查询网址:www.miit-icdc.org(自愿申请,须另行缴纳考试费500元/人)
SIMPLICITY
官方联系人