 五度妙笔
 企业透视镜
 API商城

 数据库
Sci Adv:北京大学陈语谦等提出scProtoTransformer实现跨分子-细胞-组织的多尺度参考映射
单细胞数据的快速积累使得在分子、细胞和供体水平上全面表征生物系统成为可能。然而,在不同分辨率下进行可扩展的参考映射,仍然是当前研究中的一个主要挑战。
2026年8月28日,北京大学陈语谦,中山大学由林麟和香港城市大学陈观兴共同通讯在
Science Advances
在线发表题为
scProtoTransformer: Scalable reference mapping across molecules, cells, and donors
的研究论文。
该研究提出scProtoTransformer——一种基于原型(prototype)的Transformer架构,旨在实现跨分子、细胞和供体水平的可扩展参考映射。scProtoTransformer引入了一种知识引导的原型分词器,可将基因表达投射到生物学上可解释的通路原型中,从而在保留生物语义模式的同时,有效减轻数值性批次效应。
通过利用从基础模型中提取的知识以及动态监督微调策略,scProtoTransformer能够在降低预训练需求的同时,获得稳健的生物学表征。在分子、细胞和供体水平的参考映射基准实验中,scProtoTransformer表现出与现有最优方法相当甚至更优的性能,同时通过生物学原型提供了可解释性。
总之,这些结果将scProtoTransformer确立为一个用于可扩展参考映射的统一框架,为从基因到个体的系统性理解奠定了基础。
单细胞测量和分析技术的快速发展,正在推动在基因、细胞和组织水平上对生物系统进行全面理解。数据的快速积累已使深度学习成为该领域最主流的解决方案。将注释从参考数据集映射至查询数据集,仍然是AI for Biology系统中的关键工作流程。
此外,基于图谱的参考映射可进一步支持众多下游应用。尽管已有多种方法被开发用于细胞身份注释中的参考映射,但跨分子、细胞和组织的可扩展参考映射仍是一个未被探索的领域。同时,多层次表征是构建人工智能驱动的虚拟细胞的重要基础资源。
然而,实现稳健的可扩展参考映射仍面临两大挑战。第一个是经典问题:基因表达作为数值测量,极易受到批次效应的影响。实验平台和测序深度的差异,可能导致即使同一细胞类型在不同数据集中的表达谱也表现出显著差异。
这种“数值漂移”常常掩盖真实的生物信号,导致模型学习到的是技术噪声而非生物异质性,从而降低了跨数据集、跨平台乃至跨实验室的泛化能力。因此,如何在避免批次效应干扰的同时学习具有生物学意义的细胞表征,一直是单细胞分析中的核心挑战。
近期一项关于通过域适应进行对比性细胞嵌入学习的研究,强调了通过学习表征来处理批次效应的重要性。当前的许多整合方法依赖于预定义的批次信息进行计算,但在实际场景中,批次效应的来源往往不明确,而主观的批次定义可能严重损害研究结论的稳健性。
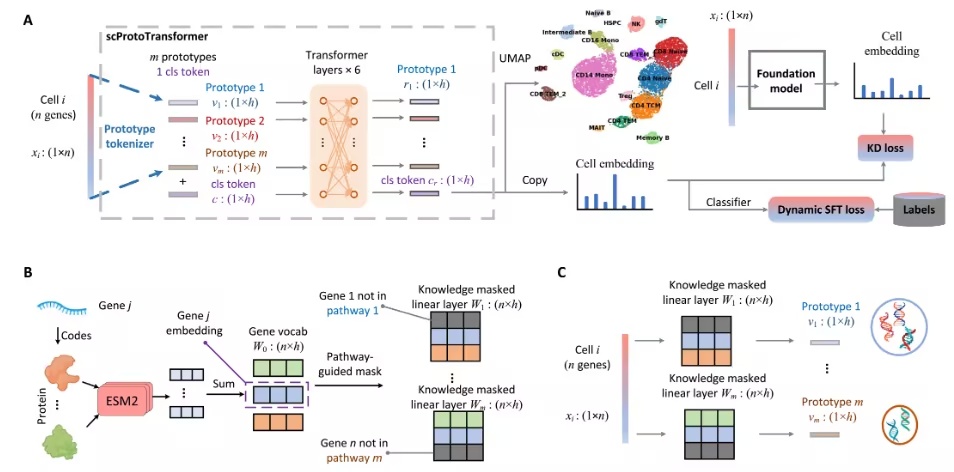
图1.scProtoTransformer的架构(摘自
Science Advances
)
第二个挑战在于现有方法目前的关注点仅限于细胞水平的参考映射。最流行的方法是使用预训练的基础模型来获取细胞表征,然后通过监督微调(SFT)将标签从参考数据迁移至查询数据。然而,跨分子、细胞和组织的参考映射尚未被探索。
生物系统本质上是分层的:在分子水平上,基因-基因相互作用影响通路等生物学功能;在细胞水平上,不同的基因集模式描述了个体细胞间的异质性;在供体水平上,由细胞群体构建的表型捕获了个体间的差异。多组学整合和癌症亚型识别方面的近期进展进一步证明了在不同分辨率下捕获生物异质性的重要性。
迄今为止,仍缺乏一个能够在分子、细胞和供体水平上同时实现表征和参考映射的多层次框架。作者设想,这样的框架不仅能捕获分子水平的基因背景,支持细胞水平的跨数据集整合和注释,还能在供体水平上泛化细胞群体特征,从而实现从分子到个体的系统性理解。
为应对这两个挑战,作者提出了scProtoTransformer——一种基于原型(prototype)的Transformer架构,用于跨分子、细胞和供体水平的可扩展参考映射。scProtoTransformer不需要主观的批次选择;相反,它将基因表达抽象为一组生物原型,从而在保留生物语义的同时减轻数值批次效应的影响。
具体而言,受计算机视觉中基于原型的建模启发,作者引入了原型分词器,其将基因表达向量线性投射到原型空间中。原型分词器的投射矩阵以生物先验知识进行初始化,确保每个原型对应一个生物学上定义明确的通路。
随后,这些原型被作为令牌输入堆叠的Transformer层,在其中自注意力机制对原型间的相互作用进行建模,从而捕获跨功能的生物学关联,同时避免原始表达值的干扰。
此外,作者为scProtoTransformer设计了一种基于基础模型引导的知识蒸馏策略。其目标是使scProtoTransformer能够继承基础模型以巨大训练成本获得的知识,而无需自身进行大规模预训练。
具体而言,作者使用一个冻结的基础模型(如scGPT)作为导航器,并利用其细胞嵌入来监督scProtoTransformer的学习。与基础模型使用的无监督预训练策略不同,作者的方法可以动态利用可用的标签:当标签存在时,其判别能力可增强scProtoTransformer的生物表征能力。
为进一步在有限数据上训练模型,作者使用动态监督微调,该策略可自适应地控制梯度以防止过拟合。
基准实验表明,scProtoTransformer支持多层次的参考映射:原型分词器通过基因嵌入支持分子水平的参考映射,细胞嵌入可用于细胞水平的参考映射,而将来自同一供体样本的所有细胞嵌入聚合至现有多示例学习(MIL)模块中,则可实现供体水平的参考映射。
总之,scProtoTransformer为跨分子、细胞和供体水平的整合分析奠定了基础。
参考消息:https://www.science.org/doi/10.1126/sciadv.aef0286


